RAG-Anything là gì: hỏi đáp trên PDF, Office, ảnh, bảng biểu
RAG-Anything là gì, cài thế nào: thư viện RAG mã nguồn mở của HKUDS đọc được cả hình, bảng, công thức trong PDF và file Office, dựng trên LightRAG.
Thử hình dung công ty anh chị vừa dựng xong chatbot hỏi đáp tài liệu nội bộ. Giám đốc gõ thử: "Quý 2 chi phí nào tăng mạnh nhất?". Chatbot trả lời rất trôi chảy, rất tự tin, và sai. Con số đúng nằm trong một bảng và một biểu đồ cột ở trang 7, mà chatbot chỉ đọc được phần chữ.
RAG-Anything sinh ra để vá đúng chỗ hổng đó.
RAG-Anything là thư viện Python mã nguồn mở của nhóm HKUDS, dùng để dựng hệ thống hỏi đáp trên tài liệu có cả chữ, hình ảnh, bảng biểu và công thức. Ngày 16/06/2025, nhóm phát hành bản v1.0.1 trên GitHub và PyPI, cùng ngày đưa phần tích hợp RAG-Anything vào LightRAG.
Đọc nhanh trong 30 giây
- RAG-Anything là thư viện Python mã nguồn mở (MIT) của HKUDS, bản v1.0.1 ngày 16/06/2025, dựng trên LightRAG.
- Nó đọc cả hình, bảng, công thức trong PDF, file Office, ảnh, rồi nối tất cả vào một đồ thị tri thức để hỏi đáp.
- Cài bằng
pip install raganythingvà MinerU 2.0 để tách tài liệu.- Hợp với doanh nghiệp có người viết Python và kho tài liệu nhiều bảng biểu.
RAG-Anything là gì, khác gì RAG thông thường?
RAG-Anything là một lớp xử lý tài liệu đa phương thức đặt trên LightRAG, giúp AI trả lời câu hỏi dựa trên toàn bộ nội dung file, kể cả phần không phải chữ. RAG là cách cho AI tra cứu tài liệu của anh chị trước khi trả lời, giống nhân viên mở hồ sơ ra xem rồi mới nói, thay vì trả lời theo trí nhớ.
Vấn đề của RAG thông thường: nó cắt tài liệu thành đoạn chữ. Giống người đọc báo chỉ đọc chữ, lướt qua mọi biểu đồ và bảng số. Một báo cáo quý có biểu đồ doanh thu và bảng chi phí thì phần quan trọng nhất lại bị bỏ qua hoặc vỡ định dạng.
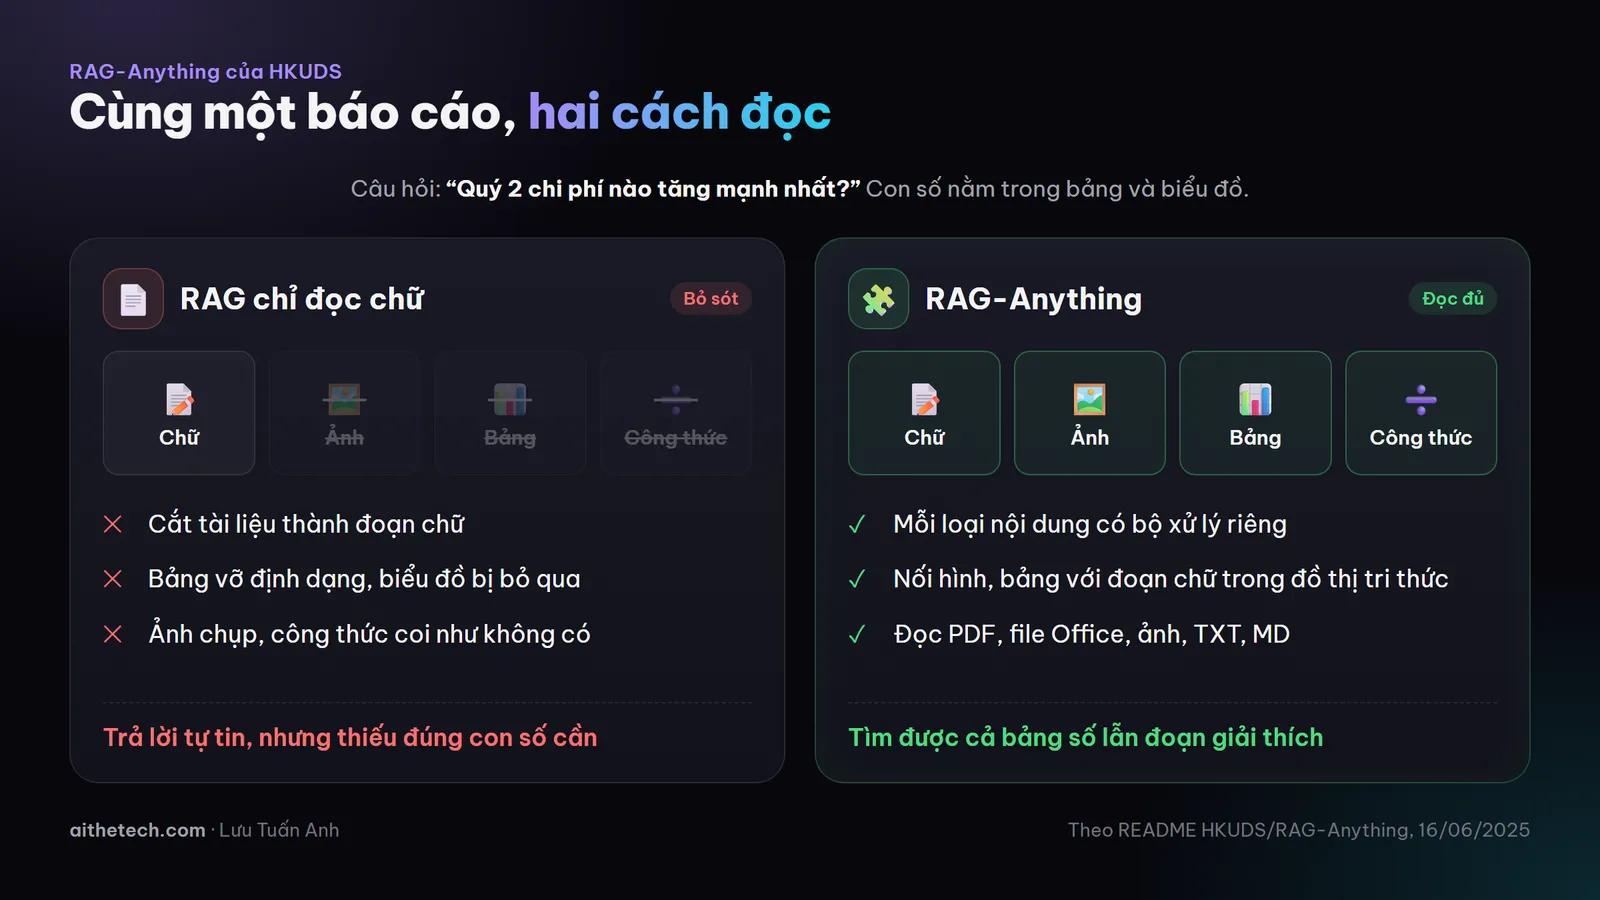
Cùng một báo cáo quý, hai cách đọc cho ra hai câu trả lời khác nhau.
RAG-Anything xử lý riêng từng loại nội dung:
- Ảnh: gửi cho mô hình đọc ảnh để viết mô tả theo ngữ cảnh.
- Bảng: phân tích dữ liệu dạng bảng, tìm quan hệ giữa các bảng.
- Công thức: đọc công thức toán, hỗ trợ định dạng LaTeX.
- Loại khác: cho phép tự viết bộ xử lý riêng.
Theo README, định dạng đọc được gồm PDF, DOC, DOCX, PPT, PPTX, XLS, XLSX, ảnh JPG, PNG, BMP, TIFF, GIF, WebP và file TXT, MD. Phần tách tài liệu dùng MinerU 2.0. Giấy phép MIT.
RAG-Anything xử lý một file qua mấy bước?
RAG-Anything đưa mỗi tài liệu qua năm giai đoạn, theo README. Giống phòng văn thư nhận một bao thư lớn: bóc ra, chia từng loại giấy tờ cho đúng người, rồi lập sổ ghi cái gì liên quan tới cái gì.
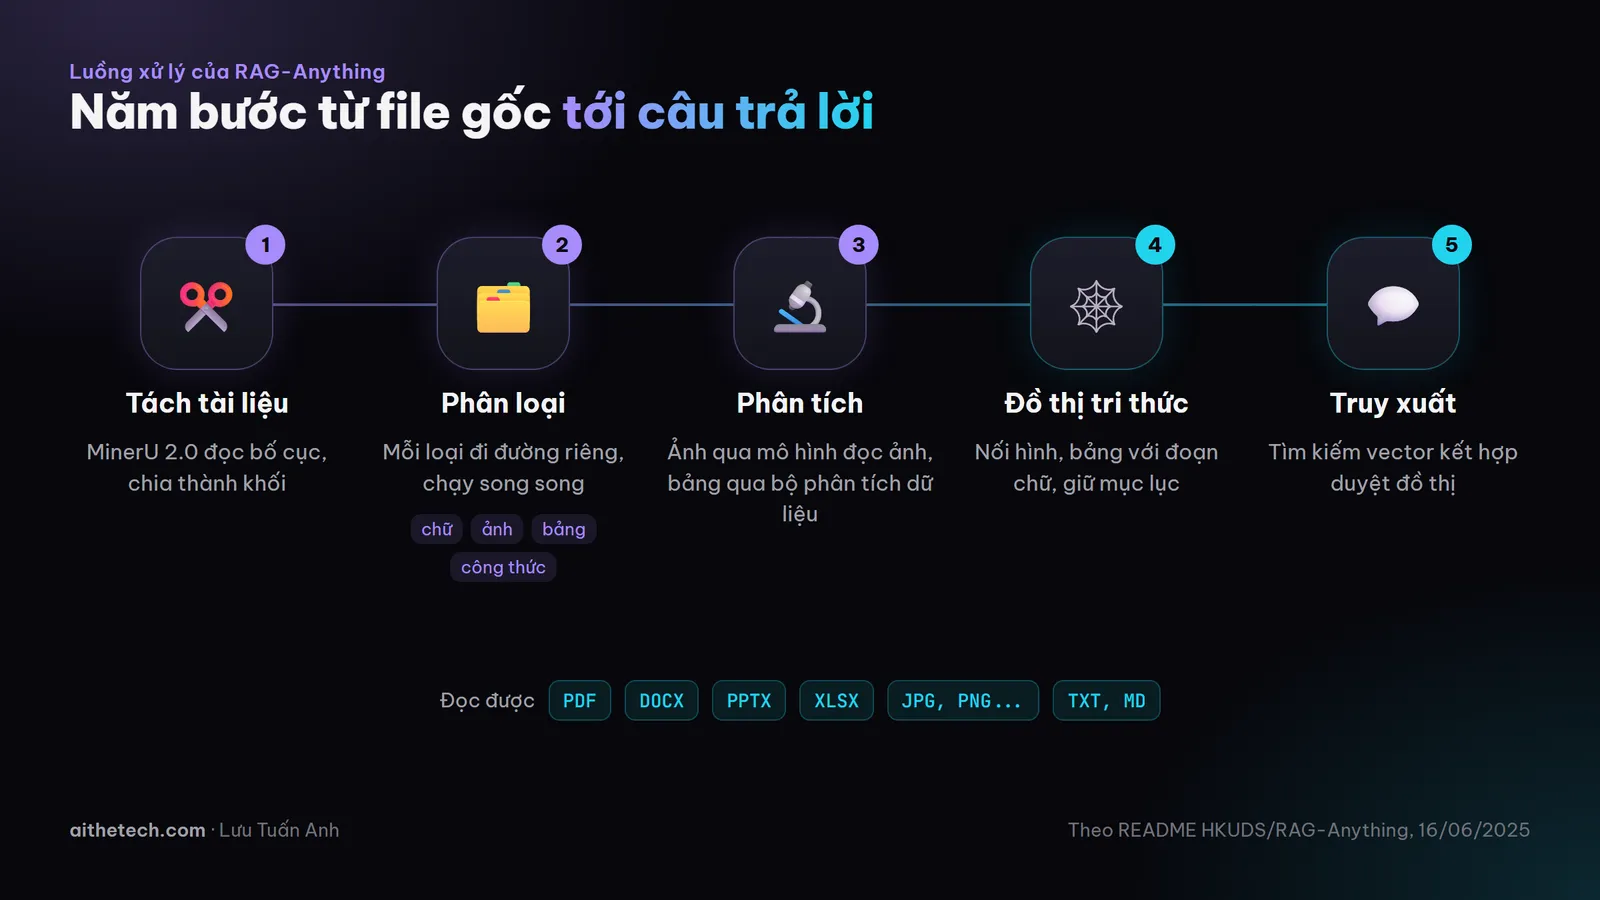
Từ file gốc tới câu trả lời: mỗi loại nội dung đi một đường riêng rồi gặp lại nhau trong đồ thị.
- Tách tài liệu: MinerU đọc bố cục, chia thành khối chữ, hình, bảng, công thức.
- Phân loại: mỗi loại nội dung đi đường xử lý riêng, chạy song song.
- Phân tích theo loại: ảnh qua mô hình đọc ảnh, bảng qua bộ phân tích dữ liệu.
- Dựng đồ thị tri thức: nối hình, bảng với đoạn chữ liên quan, giữ cấu trúc mục lục.
- Truy xuất: kết hợp tìm kiếm vector với duyệt đồ thị.
Cài RAG-Anything từng bước
Yêu cầu: Python, một khóa API cho mô hình ngôn ngữ, mô hình đọc ảnh và mô hình embedding. Ví dụ trong README dùng OpenAI.
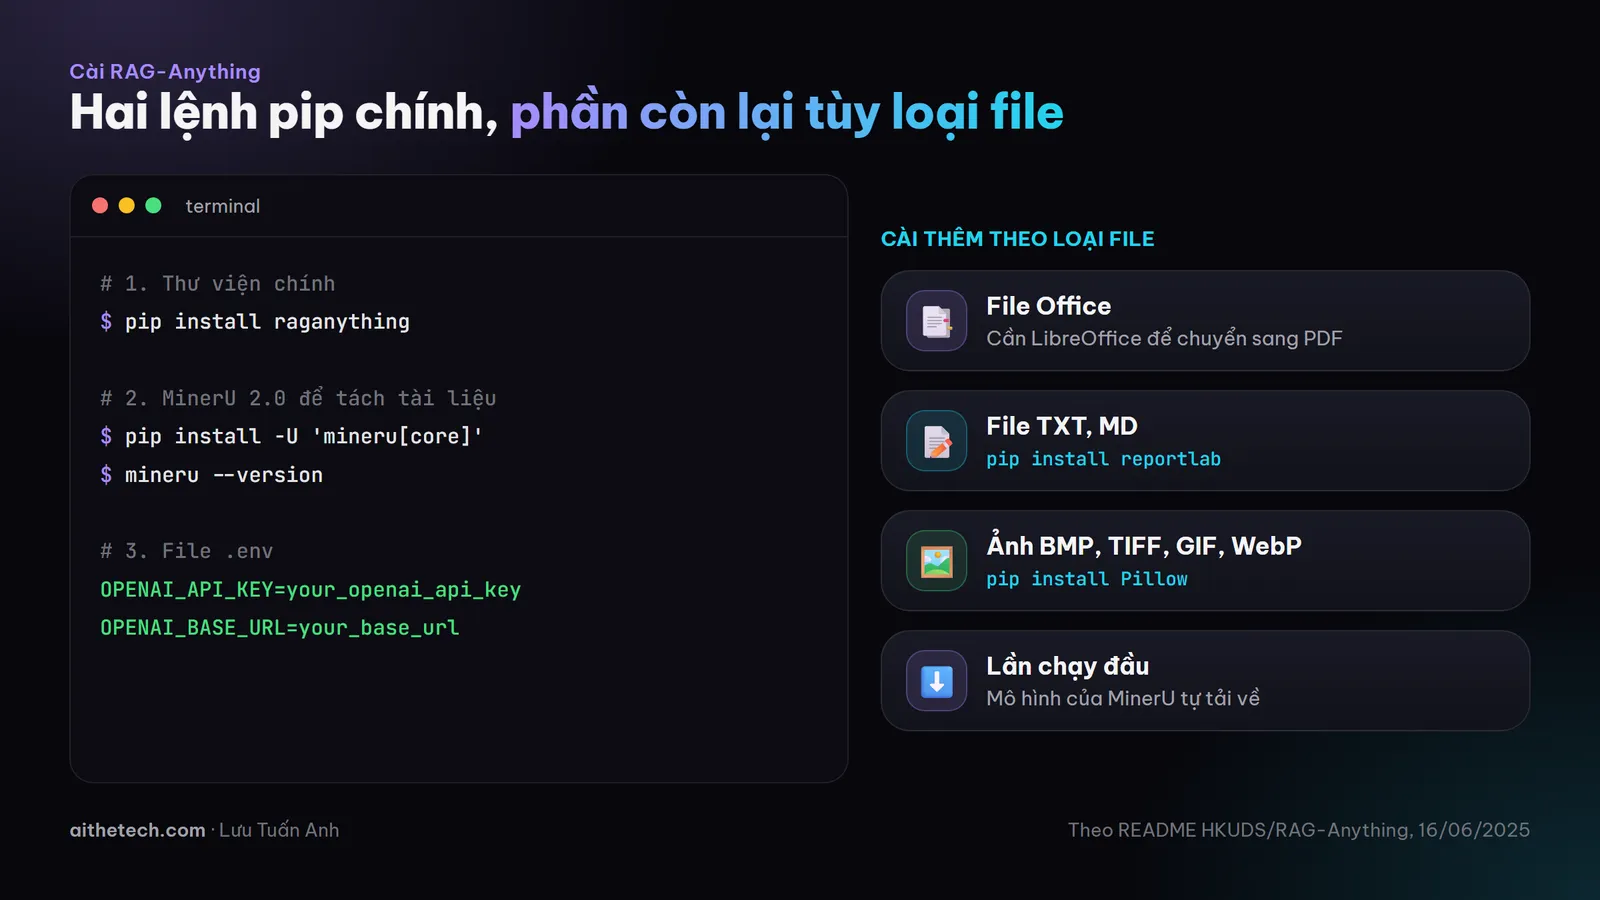
Hai lệnh pip chính, phần còn lại tùy loại file anh chị cần đọc.
- Cài thư viện từ PyPI:
pip install raganything
- Cài MinerU 2.0 để tách tài liệu, rồi kiểm tra:
pip install -U 'mineru[core]'
mineru --version
- Tạo file
.envvới khóa API:
OPENAI_API_KEY=your_openai_api_key
OPENAI_BASE_URL=your_base_url
- Cài thêm theo loại file. File Office cần LibreOffice để tự chuyển sang PDF (bản Windows tải từ trang LibreOffice). File TXT, MD cần
pip install reportlab. Ảnh BMP, TIFF, GIF, WebP cầnpip install Pillow.
README cho biết mô hình của MinerU tự tải về ở lần chạy đầu.
Thử ngay với hai việc thật
Việc 1: hỏi đáp trên một báo cáo PDF. Mã rút gọn từ ví dụ trong README, hai bước chính là xử lý file và đặt câu hỏi:
await rag.process_document_complete(
    file_path="bao-cao-quy-2.pdf",
    output_dir="./output",
    parse_method="auto"
)

result = await rag.query_with_multimodal(
    "Biểu đồ và bảng trong báo cáo cho thấy chi phí nào tăng mạnh nhất?",
    mode="hybrid"
)
Phần khởi tạo RAGAnything cần khai báo ba hàm: mô hình ngôn ngữ, mô hình đọc ảnh và mô hình embedding. README minh họa bằng gpt-4o-mini, gpt-4o và text-embedding-3-large, anh chị đổi theo nhà cung cấp mình dùng. Chế độ hỏi có hybrid, local và global.
Việc 2: nạp cả thư mục hồ sơ. Phòng kỹ thuật tòa nhà có hàng trăm file bàn giao: bản vẽ xuất PDF, bảng thông số Excel, slide đào tạo. README có hàm xử lý theo thư mục:
await rag.process_folder_complete(
    folder_path="./ho-so-ban-giao",
    output_dir="./output",
    file_extensions=[".pdf", ".docx", ".pptx"],
    recursive=True,
    max_workers=4
)
Sau đó nhân viên hỏi được "Máy bơm tầng hầm công suất bao nhiêu, bảo trì mấy tháng một lần?", hệ thống tìm cả trong bảng thông số lẫn đoạn mô tả.
Mẹo
Tài liệu chủ yếu là chữ thì chưa cần RAG-Anything. Chuyển file sang Markdown bằng MarkItDown là đủ.
Những điều cần cân nhắc
Lưu ý
- Là thư viện cho lập trình viên: chưa có giao diện bấm nút. Cần người viết Python để dựng và vận hành.
- Chi phí API: mỗi hình, mỗi bảng đều gọi mô hình để mô tả, nên tài liệu nhiều hình tốn token hơn RAG chỉ đọc chữ. README không ghi con số chi phí.
- Dữ liệu đi ra ngoài: dùng OpenAI hay nhà cung cấp đám mây khác thì nội dung tài liệu được gửi tới họ.
- Tiếng Việt: tham số
langcủa MinerU có trong README, nhưng README không nói rõ chất lượng với tài liệu tiếng Việt.- Office phụ thuộc LibreOffice: file Office được chuyển sang PDF trước rồi mới tách, bố cục phức tạp có thể bị lệch.
- Dự án còn mới: bản v0.0.1 lên PyPI ngày 09/06/2025, bản v1.0.1 ngày 16/06/2025. Giao diện hàm có thể còn thay đổi.
Nhận xét của chuyên gia
Phần lớn tài liệu doanh nghiệp Việt tôi gặp không phải văn bản sạch. Đó là báo cáo có bảng Excel dán vào Word, slide đầy biểu đồ, hồ sơ thầu quét thành PDF. RAG chỉ đọc chữ thường trả lời rất tự tin nhưng bỏ sót đúng con số người hỏi cần. RAG-Anything đi đúng hướng khi coi bảng và hình là nội dung chính. Rủi ro lớn nhất là tin kết quả quá sớm, vì mô tả ảnh và bảng do AI viết vẫn có thể đọc sai số.
Hợp với ai: doanh nghiệp đã có người làm kỹ thuật, có kho tài liệu nhiều bảng biểu (tài chính, kỹ thuật, vận hành), muốn dựng trợ lý tra cứu nội bộ và chấp nhận thử nghiệm với thư viện còn mới.
Chưa hợp với ai: doanh nghiệp chưa có ai viết code, hoặc chỉ cần hỏi đáp vài chục file chữ. Khi đó dùng tính năng tải file lên của các chatbot thương mại sẽ nhanh và rẻ hơn nhiều.
Cách bắt đầu của tôi: chọn một nhóm tài liệu hẹp, dựng thử trên một máy, đo thời gian và chi phí API cho vài file. Song song, làm một bộ 20 đến 30 câu hỏi mẫu có đáp án đúng, chạy thử và đối chiếu từng câu trước khi cho nhân viên dùng.
Một câu để nhớ: con số quan trọng nhất trong báo cáo thường nằm trong bảng, nên AI không đọc được bảng thì chưa đọc được báo cáo.
Câu hỏi thường gặp
RAG-Anything có miễn phí không?
Thư viện miễn phí theo giấy phép MIT. Phần tốn tiền là các mô hình AI anh chị kết nối vào để mô tả ảnh, phân tích bảng và trả lời câu hỏi.
RAG-Anything khác gì LightRAG?
LightRAG là hệ thống RAG dựa trên đồ thị tri thức, tập trung vào chữ. RAG-Anything dựng trên LightRAG và bổ sung phần tách tài liệu bằng MinerU cùng các bộ xử lý ảnh, bảng, công thức.
RAG-Anything có đọc được file Excel không?
Có, README liệt kê XLS và XLSX. File Office được chuyển sang PDF bằng LibreOffice rồi mới tách nội dung, nên máy cần cài LibreOffice.
Có chạy RAG-Anything hoàn toàn trong máy được không?
README chỉ minh họa bằng API của OpenAI. Về lý thuyết anh chị có thể thay bằng hàm gọi mô hình khác, nhưng README không hướng dẫn cụ thể cách chạy hoàn toàn nội bộ.
Xem thêm các mốc khác trong chuỗi ở dòng thời gian AI.
Nguồn tham khảo: https://github.com/HKUDS/RAG-Anything