LangExtract là gì: trích xuất dữ liệu từ văn bản bằng LLM
LangExtract là gì: thư viện Python mã nguồn mở của Google dùng Gemini trích xuất dữ liệu có cấu trúc từ văn bản, chỉ rõ vị trí từng thông tin trong bản gốc.
Thử hình dung thế này. Sếp giao anh chị 200 hợp đồng thuê văn phòng, cần một bảng Excel gồm tên bên thuê, diện tích, giá thuê, thời hạn, hạn chót sáng thứ Hai. Anh chị nhờ AI đọc giúp, AI trả bảng rất nhanh. Rồi sếp chỉ vào một ô: "Con số 450 nghìn này lấy ở câu nào?". Thế là anh chị lại mở từng file ra dò.
LangExtract sinh ra để trả lời đúng câu hỏi đó. LangExtract là thư viện Python mã nguồn mở của Google, dùng mô hình ngôn ngữ lớn như Gemini để trích dữ liệu có cấu trúc từ văn bản tự do, và gắn mỗi thông tin với đúng vị trí của nó trong bản gốc.
Đọc nhanh trong 30 giây
- LangExtract là thư viện Python của Google, giấy phép Apache 2.0, được giới thiệu trên blog Google for Developers ngày 30/07/2025.
- Nó đọc văn bản dài, rút ra các mục anh chị cần, và chỉ rõ từng mục nằm ở ký tự thứ bao nhiêu trong bản gốc.
- Cài bằng
pip install langextract, cần Python 3.10 trở lên và khóa API Gemini (hoặc model chạy tại máy qua Ollama).- Hợp với đội có người viết Python, đang phải biến hợp đồng, biên bản, email thành bảng dữ liệu.
LangExtract giải quyết chuyện gì?
LangExtract biến văn bản tự do thành bảng dữ liệu kiểm tra lại được. Anh chị đưa vào ba thứ: một câu mô tả việc cần trích, vài ví dụ mẫu, và văn bản cần xử lý. Đầu ra là danh sách thông tin đã phân loại, mỗi thông tin kèm vị trí ký tự trong văn bản gốc.
Ví von cho dễ nhớ: nhờ AI thông thường giống nhờ một người đọc sách rồi kể lại theo trí nhớ. LangExtract giống người vừa đọc vừa cầm bút dạ quang, tô vàng đúng chữ mình lấy, rồi dán giấy nhớ ghi "trang 3, dòng 12". Ai muốn kiểm tra chỉ cần lật tới chỗ tô vàng.
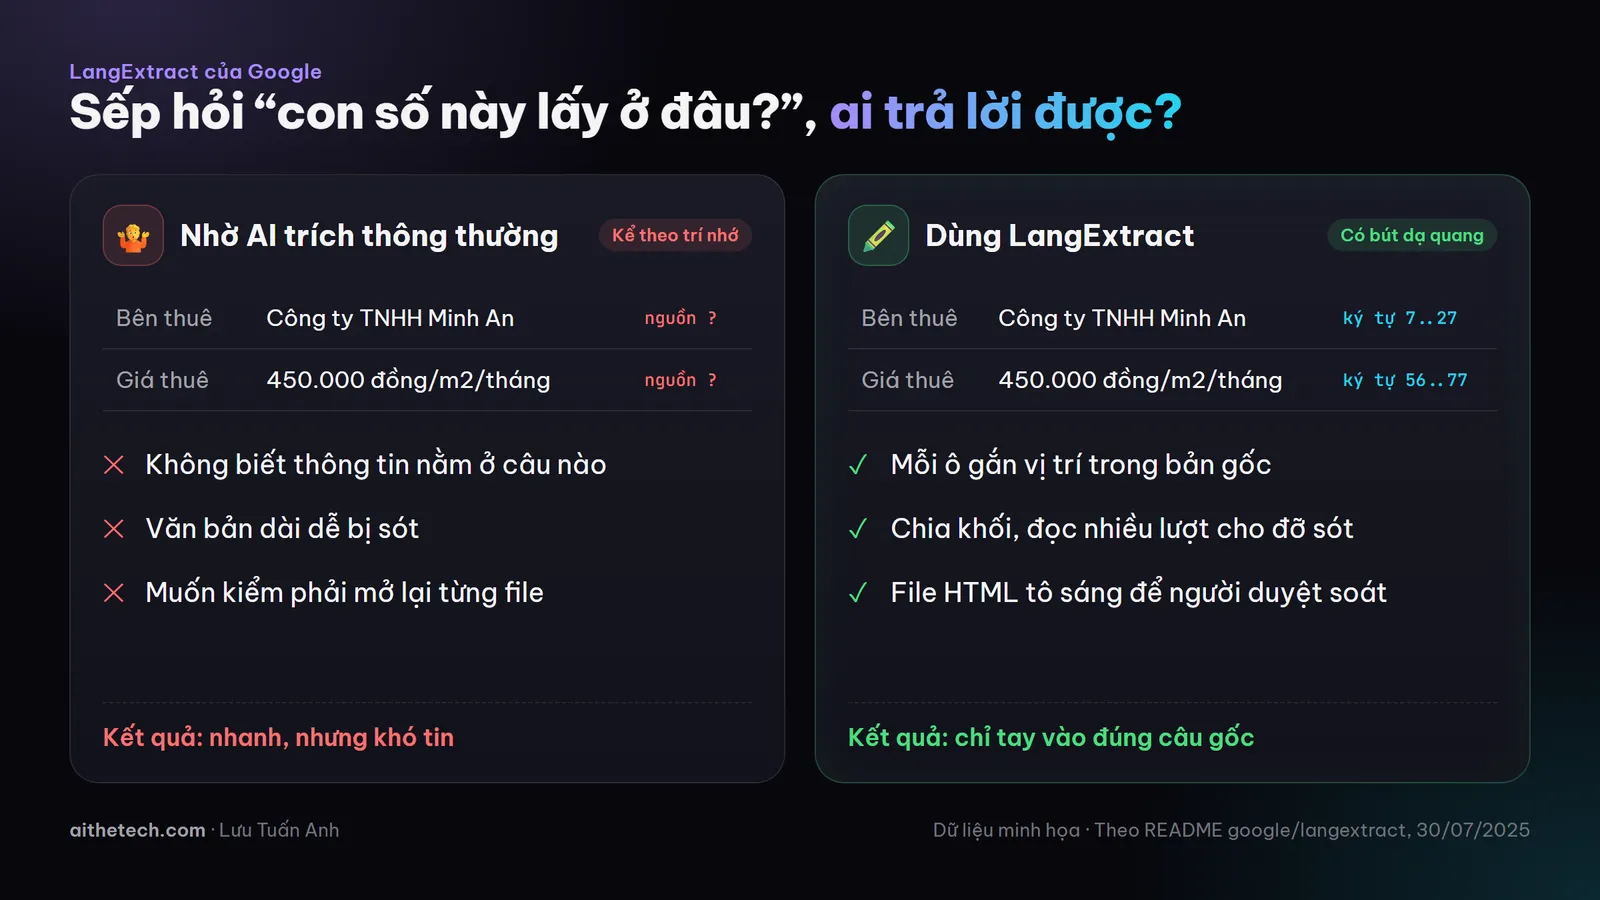
Cùng một bảng kết quả, nhưng chỉ một bên trả lời được câu "lấy ở đâu".
Theo README, LangExtract có bảy điểm chính:
- Gắn nguồn chính xác: mỗi thông tin trích ra đều chỉ về đúng chỗ trong văn bản, tô sáng được để kiểm tra.
- Đầu ra có cấu trúc ổn định: định dạng theo ví dụ mẫu, dùng tính năng sinh có kiểm soát của Gemini.
- Xử lý văn bản dài: chia nhỏ văn bản, xử lý song song và đọc nhiều lượt để không sót.
- Xem kết quả trực quan: tự sinh một file HTML để duyệt hàng nghìn thông tin trong ngữ cảnh gốc.
- Chọn model linh hoạt: Gemini trên cloud hoặc model mở chạy tại máy qua Ollama.
- Dùng cho mọi lĩnh vực: chỉ cần vài ví dụ, không cần fine-tune model.
- Tận dụng kiến thức của model: có thể cho model bổ sung thông tin suy ra, nhưng độ chính xác tùy model và ví dụ.
Bên trong LangExtract chạy thế nào?
LangExtract chạy theo một dây chuyền bốn chặng: nhận đề bài, cắt văn bản thành khối, gọi model cho từng khối, rồi ghép kết quả kèm vị trí. Văn bản dài không bị nhồi một lần vào model mà được chia nhỏ, xử lý song song.
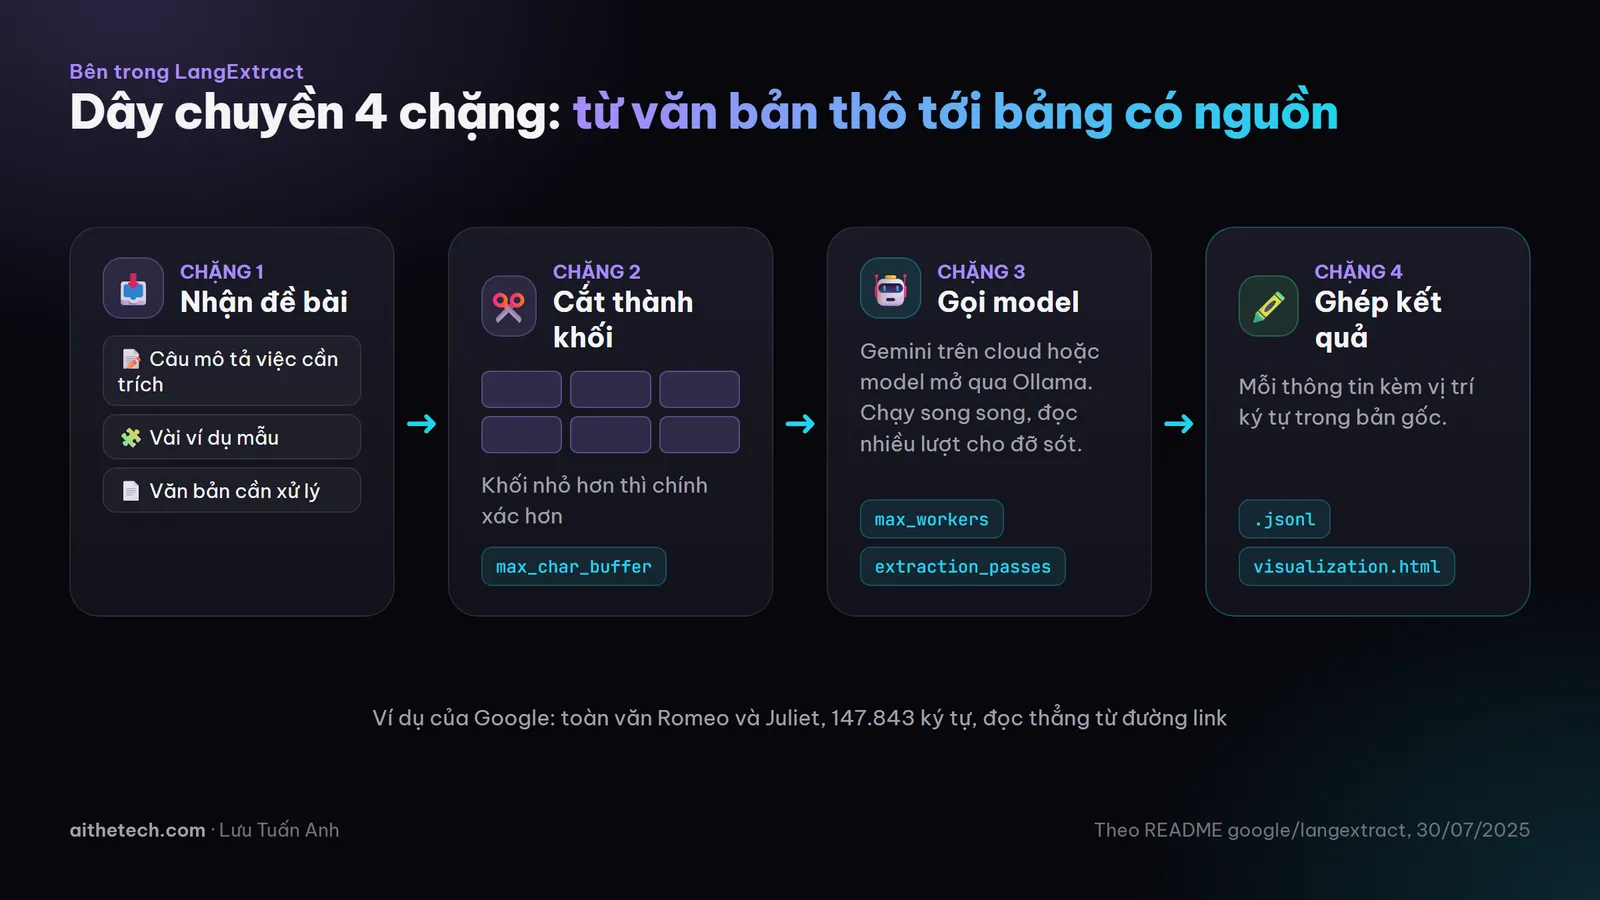
Bốn chặng từ văn bản thô tới bảng dữ liệu có gắn vị trí nguồn.
Có ba tham số đáng biết khi văn bản dài, theo README:
extraction_passes: số lượt đọc. Giống sàng gạo nhiều lần, mỗi lượt nhặt thêm hạt sạn bị sót, đổi lại tốn thêm lượt gọi model.max_workers: số luồng chạy song song, tăng thì nhanh hơn.max_char_buffer: cỡ mỗi khối văn bản, nhỏ hơn thì chính xác hơn.
Ví dụ của Google xử lý toàn văn Romeo và Juliet, 147.843 ký tự, đọc thẳng từ đường link.
Cài LangExtract trong 3 bước
Yêu cầu: Python 3.10 trở lên (theo pyproject.toml), khóa API Gemini nếu dùng model trên cloud.
- Cài từ PyPI:
pip install langextract
- Lấy khóa API Gemini tại AI Studio (hoặc Vertex AI cho doanh nghiệp), đặt vào biến môi trường:
export LANGEXTRACT_API_KEY="your-api-key-here"
- Gọi hàm
lx.extractvới mô tả, ví dụ và văn bản. Theo README,gemini-2.5-flashlà model mặc định nên dùng, cân bằng tốc độ, chi phí và chất lượng. Việc cần suy luận sâu có thể dùnggemini-2.5-pro.
Mẹo
README khuyên để khóa API trong file
.envvà thêm.envvào.gitignore. Một dòng cấu hình nhỏ, đỡ được cảnh khóa API bị đẩy lên kho code cho cả thiên hạ xem.
Lưu kết quả và sinh file xem trực quan:
lx.io.save_annotated_documents([result], output_name="extraction_results.jsonl")
html_content = lx.visualize("extraction_results.jsonl")
with open("visualization.html", "w") as f:
    f.write(html_content)
Thử với hợp đồng thuê văn phòng
Quay lại 200 hợp đồng ở đầu bài. Viết theo đúng cấu trúc ví dụ trong README, chỉ cần một ví dụ mẫu tử tế:
import langextract as lx
import textwrap

prompt = textwrap.dedent("""\
    Trích bên thuê, diện tích, giá thuê và thời hạn thuê theo thứ tự xuất hiện.
    Dùng đúng chữ trong văn bản, không diễn giải lại.""")

examples = [
    lx.data.ExampleData(
        text="Bên B: Công ty TNHH Minh An thuê 120 m2 sàn tầng 5, giá 450.000 đồng/m2/tháng, thời hạn 3 năm.",
        extractions=[
            lx.data.Extraction(extraction_class="ben_thue", extraction_text="Công ty TNHH Minh An"),
            lx.data.Extraction(extraction_class="dien_tich", extraction_text="120 m2"),
            lx.data.Extraction(extraction_class="gia_thue", extraction_text="450.000 đồng/m2/tháng"),
            lx.data.Extraction(extraction_class="thoi_han", extraction_text="3 năm"),
        ]
    )
]

result = lx.extract(
    text_or_documents=van_ban_hop_dong,
    prompt_description=prompt,
    examples=examples,
    model_id="gemini-2.5-flash",
)
Ví dụ mẫu trên là dữ liệu tôi tự đặt ra để minh họa. Mở visualization.html, anh chị thấy từng con số được tô sáng ngay trong câu gốc. Sếp hỏi "lấy ở đâu", anh chị chỉ vào màn hình là xong.
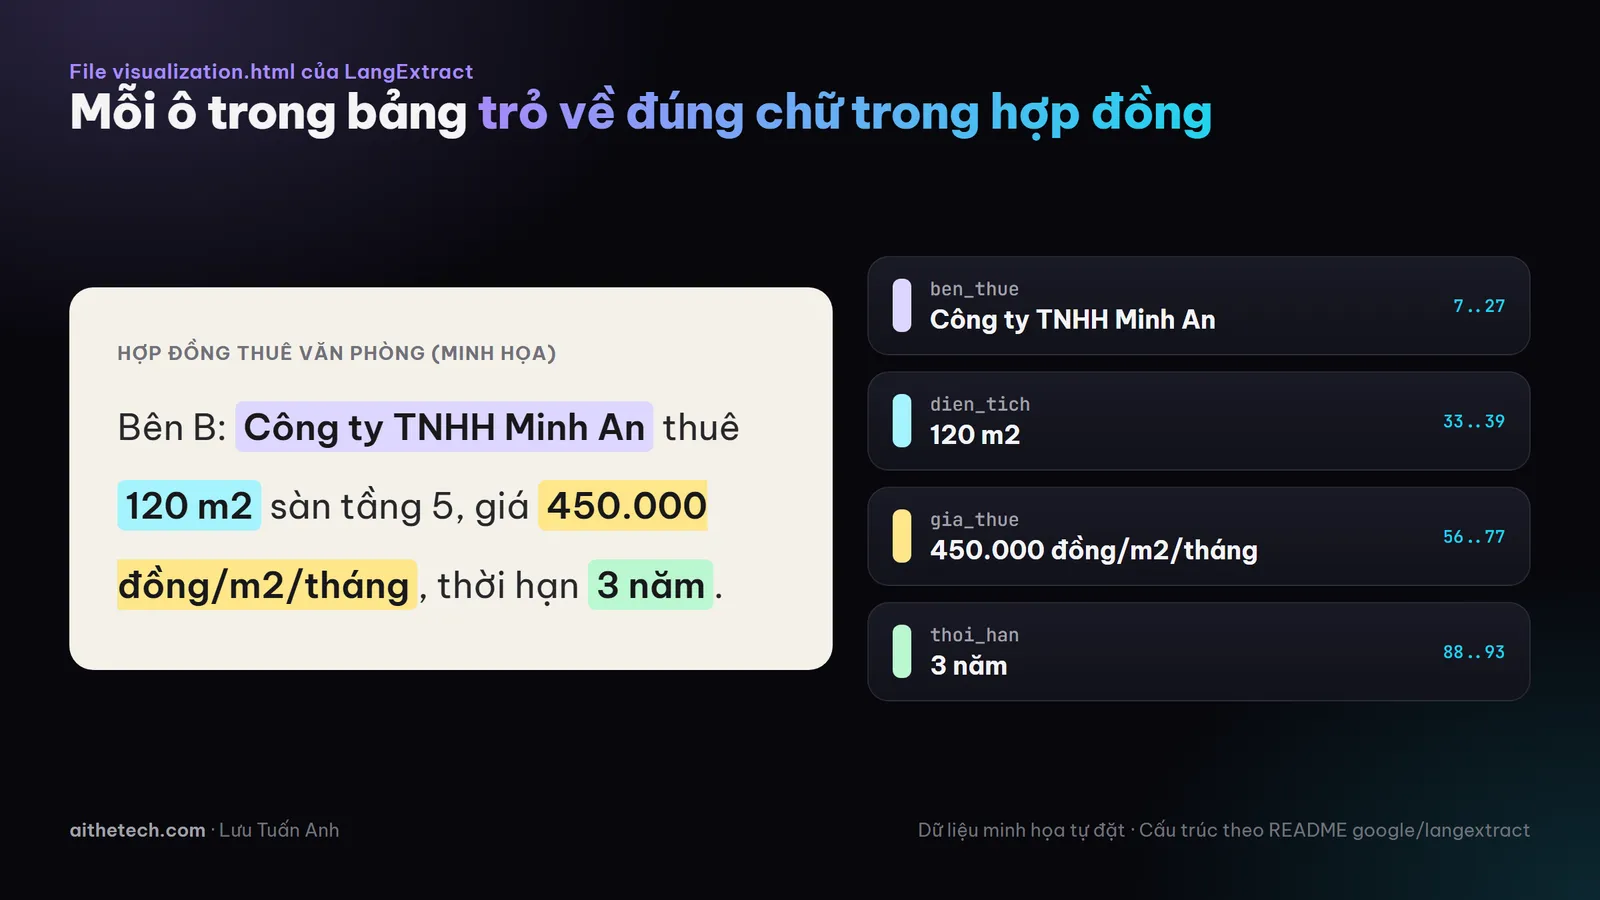
Mỗi ô trong bảng đều trỏ về đúng đoạn chữ trong hợp đồng (dữ liệu minh họa).
Nếu tài liệu đang ở dạng Word hay PDF, anh chị có thể chuyển sang văn bản trước bằng MarkItDown rồi đưa vào LangExtract.
Những chỗ cần dè chừng
Lưu ý
- Không phải sản phẩm Google hỗ trợ chính thức: README ghi rõ điều này, dù giấy phép Apache 2.0 cho phép dùng trong doanh nghiệp.
- Chi phí API: mỗi lượt đọc là một lần gọi model. Tăng
extraction_passeslên 3 nghĩa là gọi nhiều hơn. Dùng quy mô lớn, README gợi ý hạn mức Gemini Tier 2 để tránh bị giới hạn tốc độ.- Dữ liệu đi ra ngoài: dùng Gemini trên cloud thì nội dung văn bản gửi tới Google. Hồ sơ nhạy cảm nên cân nhắc model chạy tại máy qua Ollama.
- Ứng dụng y tế: ví dụ trích thuốc và báo cáo X-quang chỉ để minh họa, không phải sản phẩm y tế được phê duyệt, và còn chịu thêm điều khoản Health AI Developer Foundations.
- Thông tin suy ra: phần model tự bổ sung ngoài văn bản không có vị trí gốc để kiểm, cần duyệt kỹ.
Nhận xét của chuyên gia
Tôi đánh giá điểm mạnh nhất của LangExtract là phần gắn nguồn. Trong các dự án trích xuất tài liệu cho doanh nghiệp, câu hỏi khó nhất từ kế toán hay pháp chế luôn là "con số này lấy ở đâu". Có vị trí ký tự và file HTML tô sáng thì người duyệt kiểm nhanh hơn nhiều so với dò lại từng trang.
Hợp với ai: phòng pháp chế, kế toán, nhân sự, kinh doanh có nhiều văn bản lặp mẫu như hợp đồng, biên bản, hồ sơ ứng viên; đội kỹ thuật đang làm công cụ nội bộ bằng Python.
Chưa hợp với ai: người không viết code, vì đây là thư viện chứ không phải phần mềm có giao diện; tài liệu scan chỉ có ảnh, vì LangExtract nhận văn bản, cần qua bước nhận dạng chữ trước.
Cách bắt đầu của tôi: chọn 10 văn bản thật, tự điền bảng đáp án bằng tay, viết 2 ví dụ mẫu, chạy thử và so với đáp án. Ví dụ mẫu quyết định chất lượng: viết ẩu một ví dụ là lệch đồng loạt cả nghìn file. Đạt mức chấp nhận được rồi mới chạy hàng loạt, và luôn để người duyệt qua file HTML.
Một câu để nhớ: dữ liệu đáng tin là dữ liệu chỉ ra được chỗ nó được lấy. Với giấy tờ có chữ ký, điều đó quan trọng hơn tốc độ.
Câu hỏi thường gặp
LangExtract có miễn phí không?
Thư viện miễn phí theo giấy phép Apache 2.0. Chi phí nằm ở lượt gọi Gemini, hoặc bằng không nếu anh chị chạy model mở tại máy qua Ollama.
LangExtract có đọc được tiếng Việt không?
Tài liệu không nói riêng về tiếng Việt. Thư viện dựa vào model bên dưới, nên chất lượng với tiếng Việt phụ thuộc model anh chị chọn, cần thử trên văn bản thật.
LangExtract khác gì tự viết prompt nhờ Gemini trích dữ liệu?
Tự viết prompt cho ra kết quả nhưng không biết từng thông tin nằm ở đâu trong văn bản. LangExtract gắn vị trí nguồn, giữ định dạng đầu ra ổn định và tự chia nhỏ văn bản dài.
Có dùng LangExtract mà không gửi dữ liệu ra ngoài được không?
Được. README cho biết LangExtract hỗ trợ sẵn Ollama để chạy model mở trên máy, không cần khóa API.
Xem các mốc khác trong dòng thời gian AI 2025 tới 2026.
Nguồn: Google for Developers Blog, Introducing LangExtract, 30/07/2025.
Nguồn tham khảo: https://developers.googleblog.com/en/introducing-langextract-a-gemini-powered-information-extraction-library/