DeepSeek-R1 là gì: mô hình suy luận mã nguồn mở giấy phép MIT
DeepSeek-R1 là gì, dùng thế nào: mô hình suy luận mã nguồn mở của DeepSeek, giấy phép MIT, có bản rút gọn 1.5B tới 70B chạy trên máy riêng.
Thử hình dung thế này. Anh kế toán trưởng dán bảng chi phí quý 1 vào chatbot, hỏi "tổng có khớp không?". Chưa tới hai giây, chatbot đáp tự tin: "Khớp ạ". Anh cộng tay lại thì lệch, do một khoản bị cộng trùng.
Chatbot thường trả lời như học sinh giơ tay thật nhanh: nhanh thì có, đúng thì hên xui. DeepSeek-R1 là gì? Đó là mô hình suy luận mã nguồn mở của công ty DeepSeek, công bố ngày 20/01/2025, được dạy để nháp từng bước rồi mới nộp bài. Điểm khiến giới làm AI chú ý: theo DeepSeek, R1 ngang OpenAI o1 ở toán, code và suy luận, mà trọng số lại phát hành theo giấy phép MIT, dùng thương mại được.
Đọc nhanh trong 30 giây
- DeepSeek-R1 là mô hình suy luận của DeepSeek, ra ngày 20/01/2025, giấy phép MIT, tải về và dùng thương mại được.
- Trước khi trả lời, R1 viết một chuỗi suy nghĩ dài, tự kiểm tra, tự sửa. Hợp với toán, code, phân tích nhiều bước.
- Dùng theo ba đường: chat web có nút DeepThink, API kiểu OpenAI, hoặc tự chạy bản rút gọn 1.5B tới 70B.
- Hợp với doanh nghiệp cần AI "nghĩ kỹ" mà muốn giữ dữ liệu trong nhà.
DeepSeek-R1 khác chatbot thường ở đâu?
DeepSeek-R1 là một "reasoning model": mô hình viết ra suy nghĩ của mình trước, rồi mới chốt đáp án. Câu trả lời chậm hơn, nhưng ở bài khó thì ít sai hơn.
Ví von cho dễ nhớ: chatbot thường giống người bán hàng nhẩm giá trong đầu rồi nói luôn. R1 giống chị thủ quỹ cẩn thận, lấy giấy bút cộng từng dòng, cộng xong còn soát lại một lượt. Anh chị được xem cả tờ giấy nháp đó, nên sai ở đâu là thấy ngay ở đó.
Theo README trên GitHub, DeepSeek phát hành cùng lúc ba nhóm mô hình:
- DeepSeek-R1-Zero: huấn luyện thẳng bằng reinforcement learning trên mô hình nền, không qua bước dạy mẫu. Giống thả một người vào phòng làm bài tập, chỉ chấm đúng sai, để họ tự mò ra cách nghĩ. README cho biết R1-Zero hay lặp vô tận, khó đọc và trộn ngôn ngữ.
- DeepSeek-R1: bản chính, sửa các tật trên bằng cách cho học một ít dữ liệu mẫu trước khi vào reinforcement learning.
- Sáu mô hình rút gọn (distill): dùng dữ liệu do R1 sinh ra để dạy lại các mô hình nhỏ dựa trên Qwen2.5 và Llama3, cỡ 1.5B, 7B, 8B, 14B, 32B và 70B (bản 8B và 70B dựa trên Llama, còn lại dựa trên Qwen).
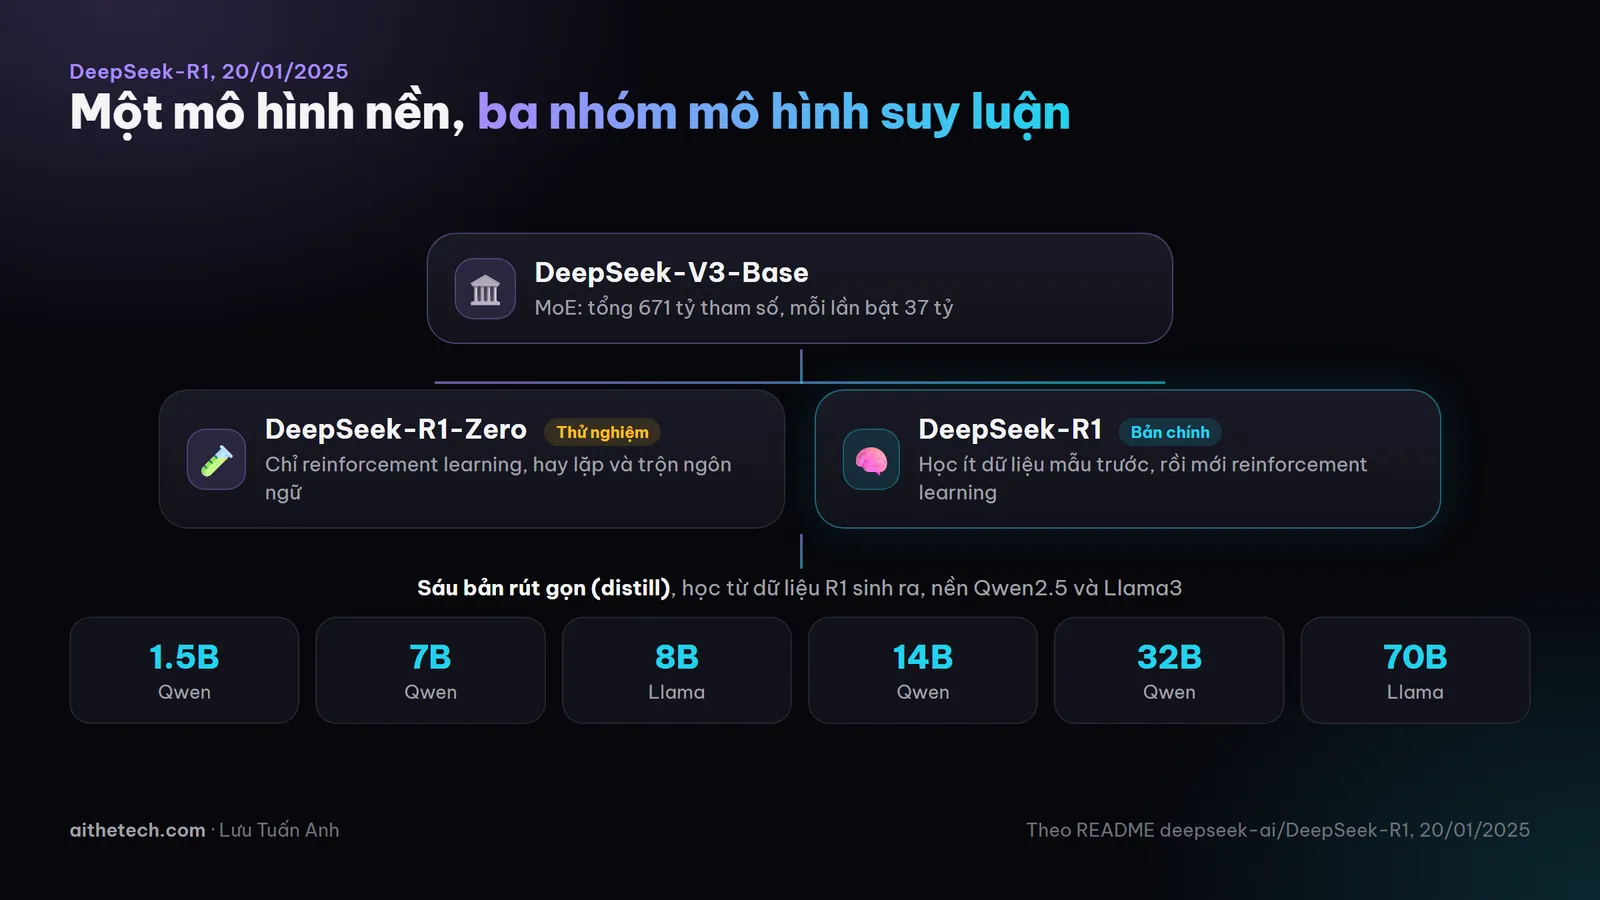
Một mô hình nền, hai bản suy luận lớn, sáu "học trò" nhỏ.
Cả R1-Zero và R1 đều xây trên DeepSeek-V3-Base theo kiến trúc MoE: tổng 671 tỷ tham số nhưng mỗi lần chỉ bật 37 tỷ, độ dài ngữ cảnh 128K. Hình dung một bệnh viện lớn đủ mọi khoa, nhưng bệnh nhân đau răng chỉ vào khoa răng, không ai gọi cả viện ra khám. Các bản rút gọn thì dùng toàn bộ tham số của mình, README không ghi riêng độ dài ngữ cảnh.
DeepSeek-R1 đọ sức OpenAI o1 ra sao?
DeepSeek-R1 ngang OpenAI o1 ở phần lớn bài kiểm tra toán và code, theo bảng đánh giá do chính DeepSeek công bố trong README.
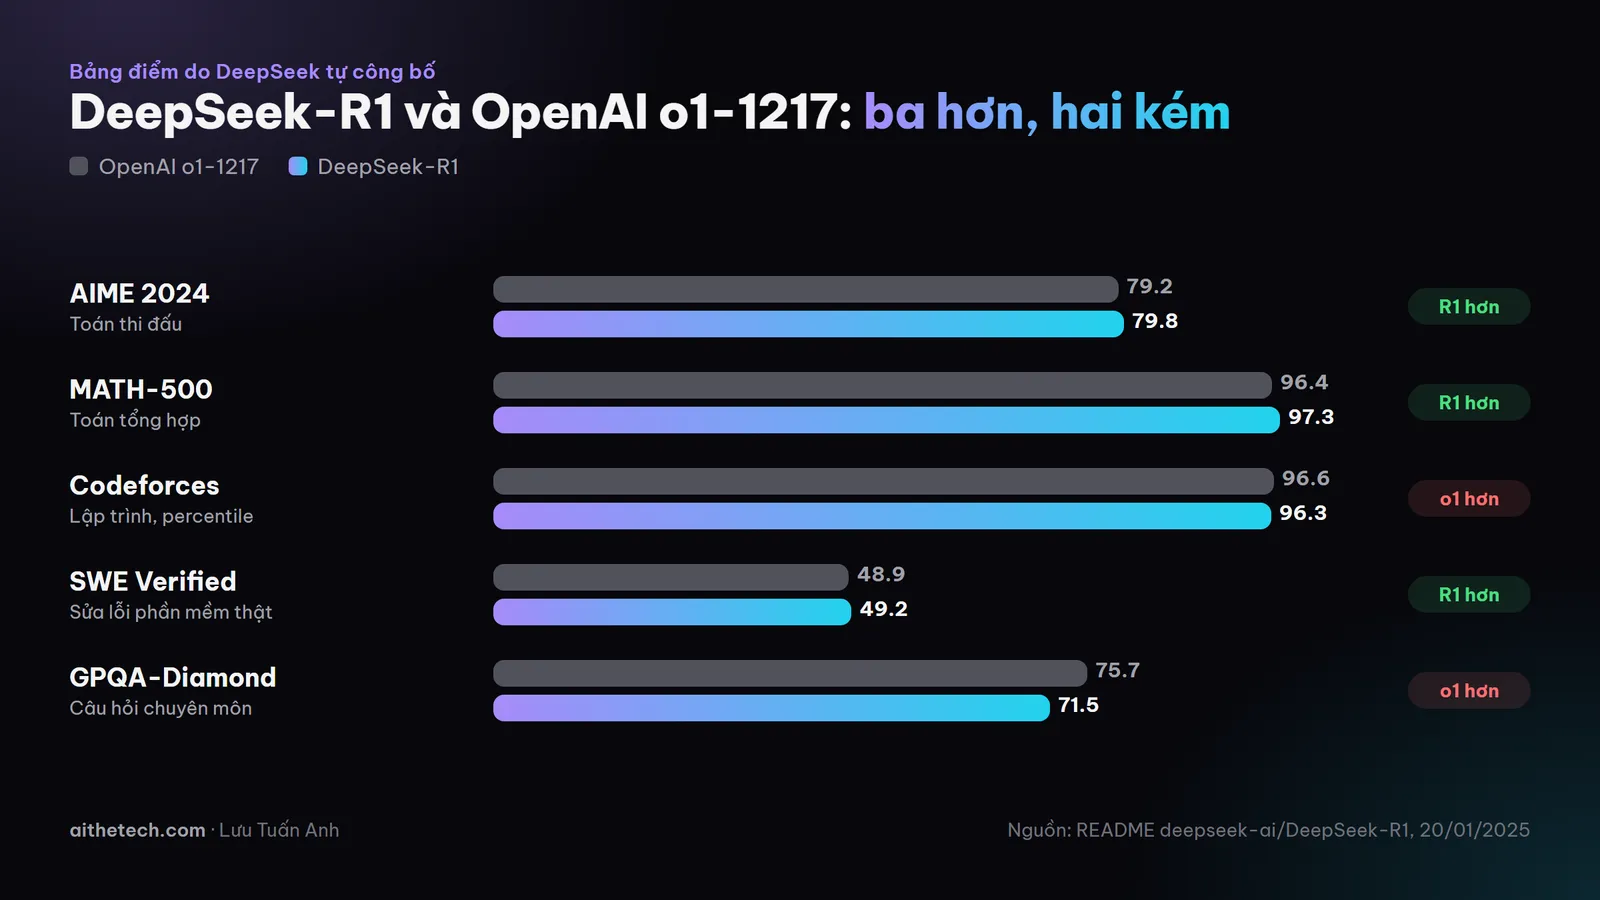
Năm bài kiểm tra: R1 nhỉnh hơn ở ba, kém hơn ở hai. Số do DeepSeek tự công bố.
| Bài kiểm tra | OpenAI o1-1217 | DeepSeek-R1 |
|---|---|---|
| AIME 2024 (toán) | 79.2 | 79.8 |
| MATH-500 | 96.4 | 97.3 |
| Codeforces (percentile) | 96.6 | 96.3 |
| SWE Verified (sửa lỗi phần mềm thật) | 48.9 | 49.2 |
| GPQA-Diamond (câu hỏi chuyên môn) | 75.7 | 71.5 |
Bản rút gọn cũng đáng để mắt: theo DeepSeek, R1-Distill-Qwen-32B vượt OpenAI o1-mini ở nhiều bài kiểm tra.
Lưu ý
Đây là số hãng tự chấm cho mình. Bảng đánh giá chỉ có tiếng Anh và tiếng Trung, README không nói gì về chất lượng tiếng Việt. Trước khi tin, hãy thử trên chính dữ liệu của công ty.
Ba đường để bắt đầu dùng DeepSeek-R1
README đưa ra ba đường, từ dễ tới khó.
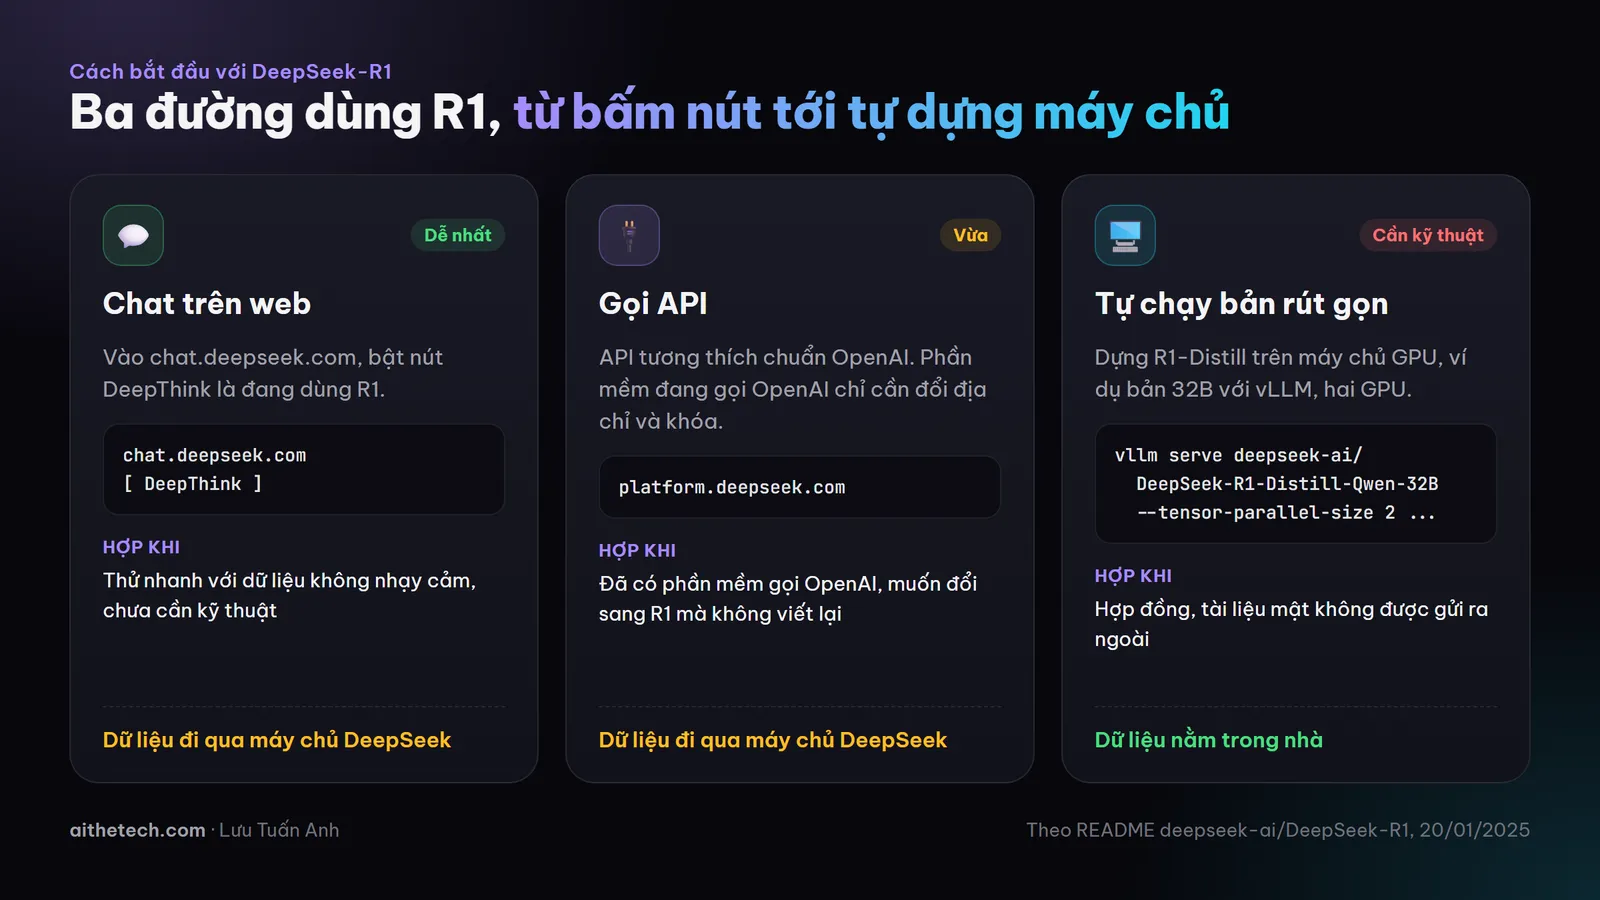
Từ bấm một nút trên web tới dựng máy chủ riêng trong văn phòng.
- Chat trên web: vào chat.deepseek.com, bật nút "DeepThink" để dùng R1.
- Gọi API: DeepSeek có API tương thích chuẩn OpenAI tại platform.deepseek.com. Phần mềm nào đang gọi OpenAI thì đổi địa chỉ và khóa là chạy.
- Tự chạy trên máy chủ riêng: bản đầy đủ 671B chạy theo hướng dẫn ở repo DeepSeek-V3. Bản rút gọn dùng như mô hình Qwen hoặc Llama thường. Lệnh mẫu trong README với vLLM:
vllm serve deepseek-ai/DeepSeek-R1-Distill-Qwen-32B --tensor-parallel-size 2 --max-model-len 32768 --enforce-eager
Hoặc với SGLang:
python3 -m sglang.launch_server --model deepseek-ai/DeepSeek-R1-Distill-Qwen-32B --trust-remote-code --tp 2
Mẹo
DeepSeek dặn bốn điều khi dùng R1: đặt temperature từ 0.5 tới 0.7 (khuyên 0.6) để tránh lặp; không dùng system prompt, đưa mọi chỉ dẫn vào tin nhắn người dùng; bài toán thì yêu cầu đặt đáp án cuối trong
\boxed{}; đánh giá thì chạy nhiều lần rồi lấy trung bình.
Giao cho R1 việc gì thì đáng?
DeepSeek-R1 đáng dùng ở việc cần nghĩ nhiều bước, nơi một câu trả lời sai tốn kém hơn vài giây chờ.
Tình huống 1: soát bảng tính giá. Quay lại anh kế toán trưởng ở đầu bài. Lần này anh bật DeepThink và gõ:
Đây là bảng chi phí dự án quý 1. Hãy kiểm tra từng dòng: tổng có khớp không, có khoản nào bị cộng trùng không, tỷ lệ phần trăm có tính đúng trên tổng không. Liệt kê lỗi theo số dòng.
Chuỗi suy nghĩ hiện ra trước đáp án: sai chỗ nào, anh bắt được ngay chỗ đó.
Tình huống 2: chạy nội bộ cho dữ liệu nhạy cảm. Công ty không muốn gửi hợp đồng ra ngoài có thể dựng R1-Distill-Qwen-32B trên máy chủ có GPU trong văn phòng bằng lệnh vLLM ở trên, rồi cho phần mềm nội bộ gọi vào như gọi API OpenAI.
Những điều cần biết trước khi dùng
- Giấy phép: mã nguồn và trọng số theo MIT, cho phép dùng thương mại, sửa đổi, kể cả dùng để dạy mô hình khác. Các bản rút gọn kế thừa giấy phép gốc: bản Qwen theo Apache 2.0, bản Llama theo giấy phép Llama 3.1 và 3.3. Đóng gói vào sản phẩm thì đọc kỹ từng cái.
- Phần cứng: bản 671B cần cụm máy chủ lớn. Lệnh mẫu bản 32B dùng hai GPU. README không ghi cấu hình tối thiểu.
- Dữ liệu: dùng web và API thì nội dung đi qua máy chủ của DeepSeek. Tài liệu mật nên đi đường tự chạy.
- Tốc độ: độ dài sinh tối đa trong bài đánh giá là 32.768 token. R1 nghĩ dài, không hợp với chatbot chăm sóc khách hàng cần trả lời tức thì.
Nhận xét của chuyên gia
Với doanh nghiệp Việt, DeepSeek-R1 quan trọng ở chỗ lần đầu có một mô hình suy luận mạnh mà mình được tải về, chạy trong nhà và dùng thương mại. Trước đây muốn dùng loại AI "nghĩ trước khi nói" thì gần như phải gửi dữ liệu cho một hãng Mỹ.
Hợp với ai: công ty có bộ phận kỹ thuật muốn dựng AI nội bộ cho phân tích, lập trình, rà tài liệu; ngành có dữ liệu nhạy cảm như tài chính, bất động sản, pháp lý; nhóm muốn thử nghiệm với chi phí thấp.
Chưa hợp với ai: doanh nghiệp chưa có người kỹ thuật mà lại muốn tự chạy bản lớn; việc cần trả lời nhanh, ngắn; nơi có quy định hạn chế dịch vụ đám mây đặt ở nước ngoài thì chỉ nên đi đường tự chạy.
Cách bắt đầu của tôi: đừng lấy bảng điểm của hãng làm căn cứ. Tuần đầu cho một nhóm nhỏ dùng bản web với dữ liệu không nhạy cảm, chọn 20 tới 30 việc thật của công ty, để R1 và công cụ đang dùng cùng làm, rồi nhờ chính người làm nghề chấm. Thấy ổn thì thử bản rút gọn 7B hoặc 14B trên một máy có GPU để đo tiếng Việt, cuối cùng mới tính bản lớn hoặc API.
Một câu để nhớ: R1 không trả lời nhanh hơn, nó cho anh chị xem tờ nháp, và tờ nháp ấy mới là thứ đáng tiền.
Câu hỏi thường gặp
DeepSeek-R1 có miễn phí không?
Trọng số DeepSeek-R1 phát hành theo giấy phép MIT, tải về và dùng thương mại không mất phí bản quyền. Chi phí nằm ở phần cứng nếu tự chạy, hoặc phí API nếu gọi qua nền tảng của DeepSeek.
DeepSeek-R1 khác gì DeepSeek-V3?
DeepSeek-R1 được huấn luyện thêm từ DeepSeek-V3-Base để suy luận nhiều bước trước khi trả lời. V3 là mô hình trò chuyện thường, R1 chuyên cho bài cần nghĩ kỹ như toán và code.
Máy tính văn phòng có chạy được DeepSeek-R1 không?
Bản đầy đủ 671B thì không. Các bản rút gọn nhỏ như 1.5B hoặc 7B dùng được như mô hình Qwen thường, nhưng README không ghi cấu hình máy tối thiểu.
Xem các mốc tiếp theo trong chuỗi dòng thời gian AI.
Nguồn tham khảo: https://github.com/deepseek-ai/DeepSeek-R1