DeepSeek-OCR là gì: nén ngữ cảnh bằng hình ảnh cho LLM
DeepSeek-OCR là gì: model mã nguồn mở của DeepSeek đọc tài liệu bằng ít vision token, chuyển ảnh, PDF sang Markdown. Cách cài, cách dùng, giới hạn.
Thử hình dung kho lưu trữ của một công ty mười năm tuổi. Ba dãy tủ sắt, mỗi tủ vài nghìn trang hợp đồng scan. Sếp hỏi "hợp đồng nào có điều khoản phạt chậm thanh toán trên 5%?", và cả phòng hành chính mất một tuần lật từng tập.
Ngày 20/10/2025, DeepSeek công bố DeepSeek-OCR: một model đọc ảnh tài liệu rồi chép lại thành chữ, thành Markdown. Nhưng điều làm giới kỹ thuật bàn tán không phải chuyện OCR, mà là câu hỏi DeepSeek đặt ra phía sau nó.
Đọc nhanh trong 30 giây
- DeepSeek-OCR là model mã nguồn mở (giấy phép MIT) của DeepSeek, phát hành ngày 20/10/2025.
- Nó đọc ảnh, PDF và xuất ra chữ hoặc Markdown, dùng rất ít "token hình ảnh" so với các model khác.
- Cài bằng Conda, PyTorch, vLLM theo README; cần GPU NVIDIA.
- Hợp với đơn vị có kho hồ sơ scan lớn và đội kỹ thuật vận hành GPU.
DeepSeek-OCR là gì?
DeepSeek-OCR là model mã nguồn mở của DeepSeek gồm hai phần: bộ mã hóa DeepEncoder biến ảnh độ phân giải cao thành một số ít vision token, và bộ giải mã DeepSeek3B-MoE-A570M đọc các token đó để viết ra chữ. Bài báo kèm theo có tên "Contexts Optical Compression", tức nén ngữ cảnh bằng đường hình ảnh.
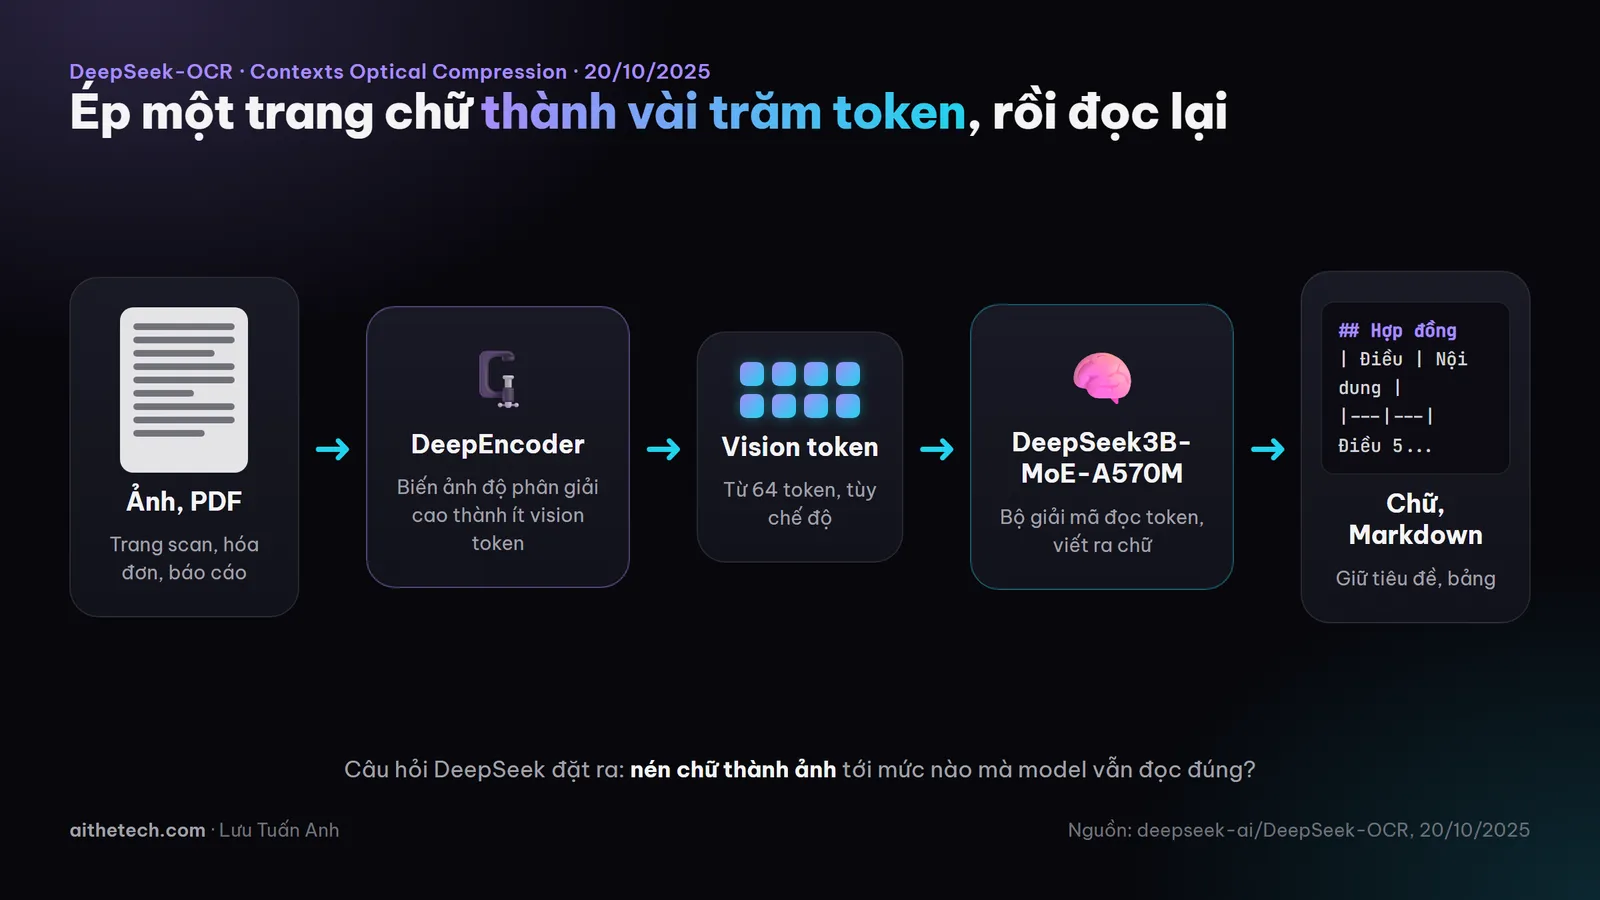
Một trang dày chữ được ép thành vài trăm token, rồi bung ra lại thành văn bản.
Vision token là những mẩu thông tin model rút ra từ ảnh, giống từng "miếng" mà model nhai. Càng ít miếng thì nhai càng nhanh, càng rẻ, miễn là vẫn nuốt đủ chất.
Vì sao DeepSeek lại nén chữ thành ảnh?
DeepSeek muốn đo xem một đoạn văn dài, khi chụp thành ảnh, có thể nén tới mức nào mà model vẫn đọc lại đúng. Nếu ảnh gọn hơn chữ, thì sau này agent đọc tài liệu dài sẽ tốn ít ngữ cảnh hơn.
Ví von đời thường: muốn gửi một cuốn sổ cho đồng nghiệp ở xa, anh chị có thể gõ lại từng chữ, hoặc chụp ảnh từng trang. Ảnh gọn hơn nhiều, người nhận vẫn đọc được. Thêm một bước nữa: cho ảnh qua máy photo thu nhỏ. Thu nhỏ một nửa vẫn đọc ngon. Thu nhỏ quá tay thì chữ nhòe, đọc chỗ được chỗ không.
Bài báo của nhóm DeepSeek đo đúng chuyện "thu nhỏ tới đâu":
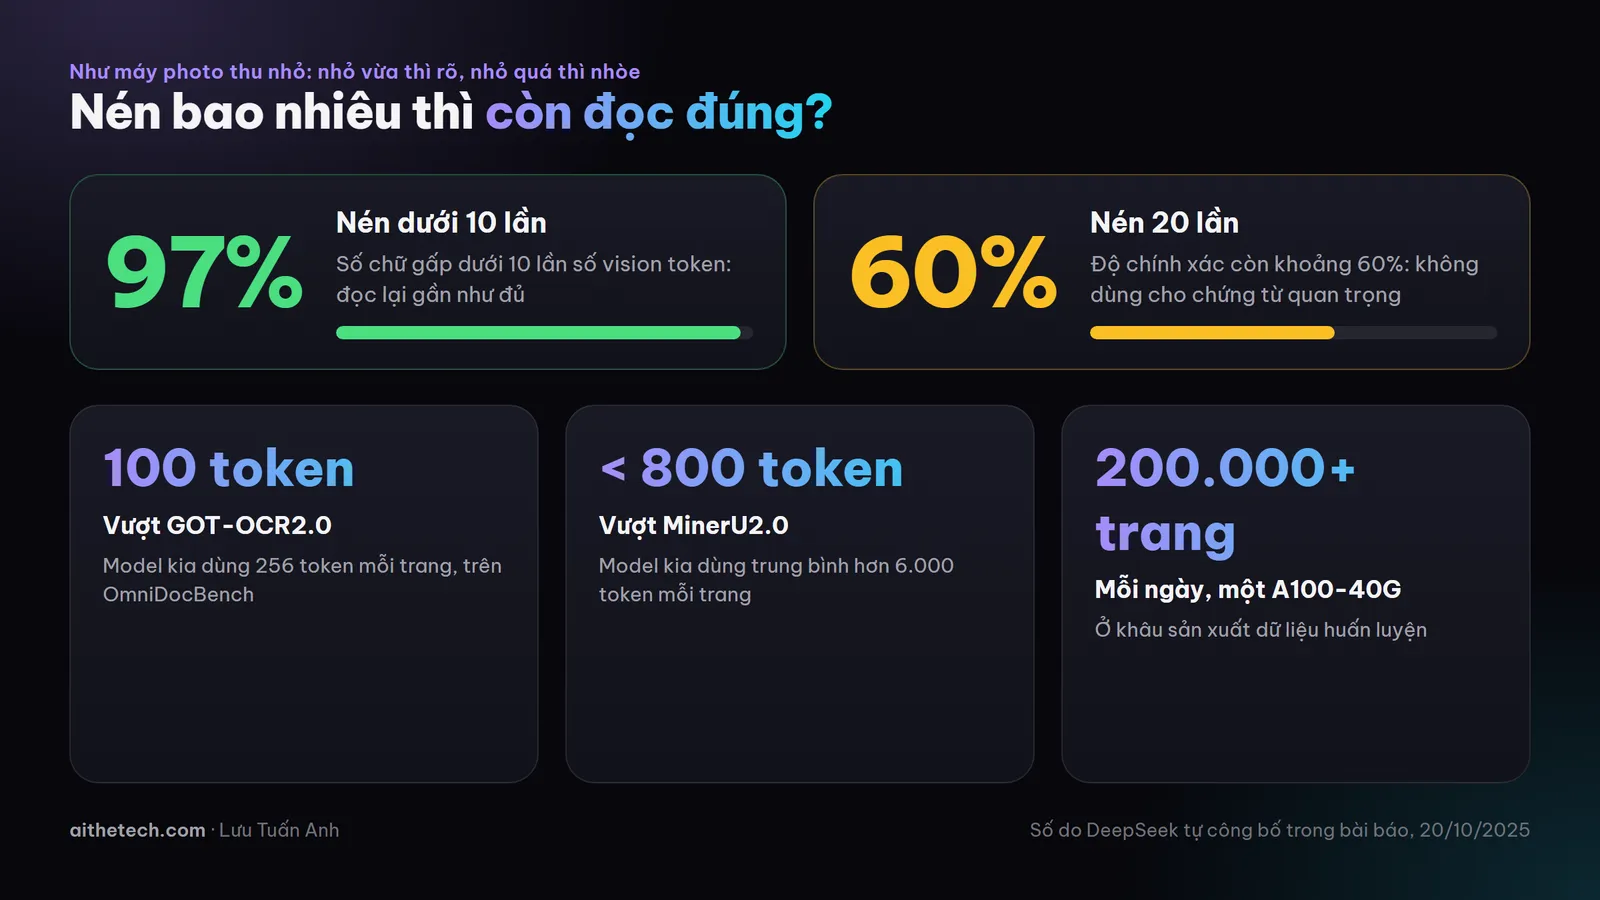
Nén nhẹ thì gần như không mất chữ, nén mạnh thì mất nhiều. Số theo DeepSeek tự công bố.
| Mức nén (số chữ trên số vision token) | Độ chính xác khi đọc lại |
|---|---|
| Dưới 10 lần | 97% |
| 20 lần | Khoảng 60% |
Cũng theo bài báo, trên bộ kiểm tra OmniDocBench, DeepSeek-OCR vượt GOT-OCR2.0 (256 token mỗi trang) khi chỉ dùng 100 vision token, và vượt MinerU2.0 (trung bình hơn 6.000 token mỗi trang) khi dùng dưới 800 vision token. Ở khâu sản xuất dữ liệu, một GPU A100-40G xử lý được hơn 200.000 trang mỗi ngày. Đây là số DeepSeek tự công bố.
Chọn chế độ nào cho tài liệu của mình?
DeepSeek-OCR có năm chế độ độ phân giải theo README. Chọn chế độ là chọn giữa tốc độ và độ chi tiết, giống chọn độ phân giải khi bấm máy scan.
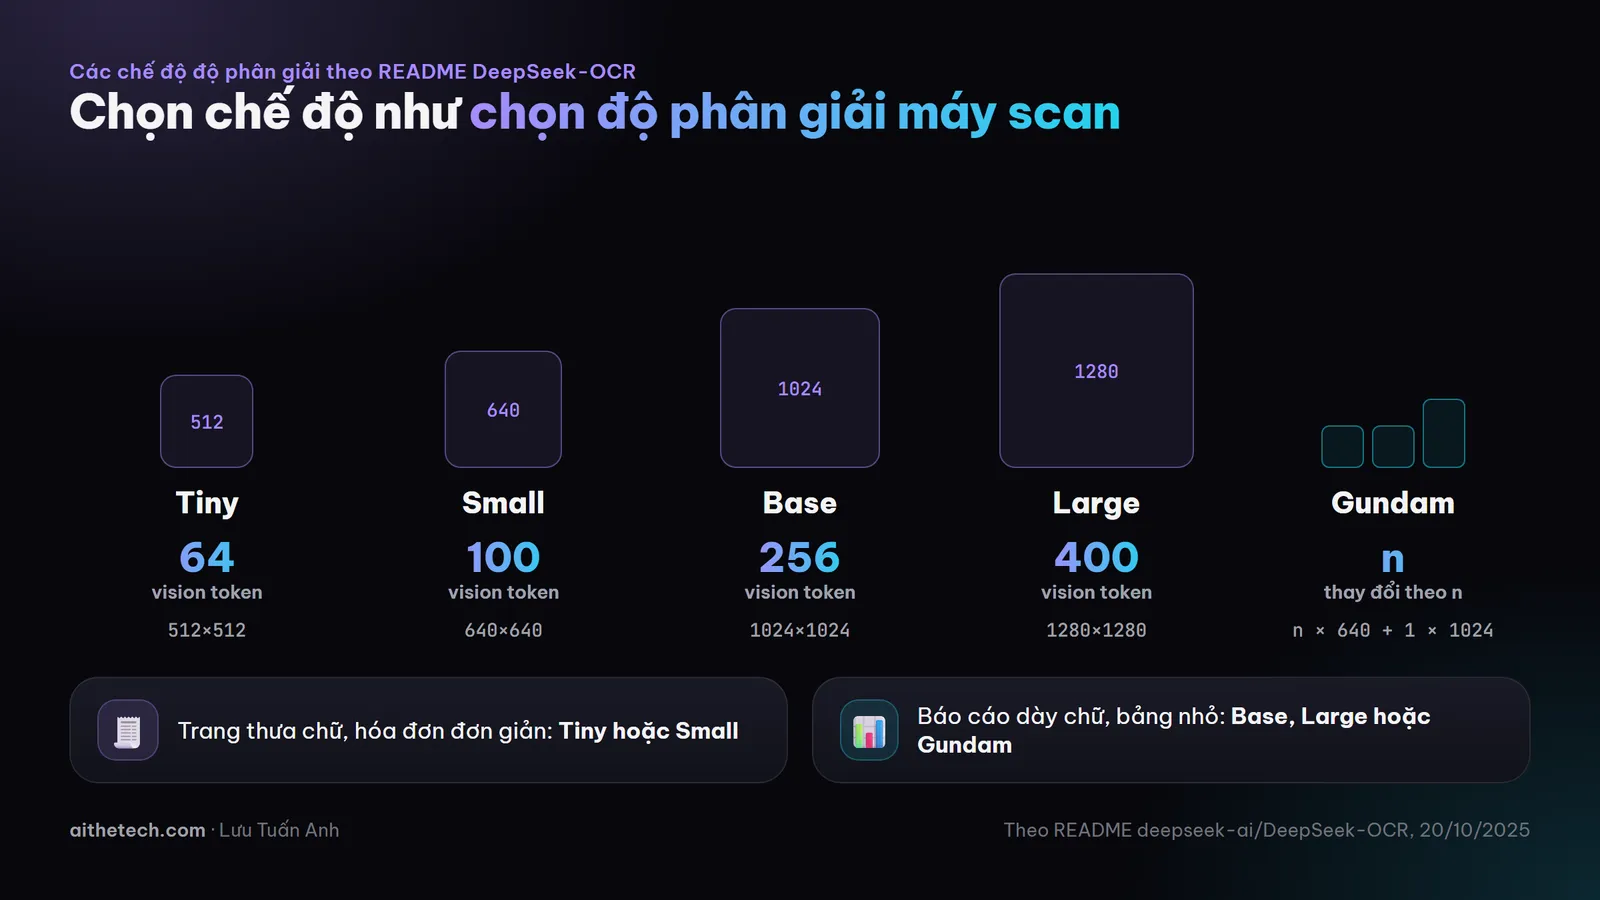
Trang thưa chữ dùng chế độ nhỏ, báo cáo dày bảng biểu dùng chế độ lớn.
| Chế độ | Kích thước ảnh | Số vision token |
|---|---|---|
| Tiny | 512×512 | 64 |
| Small | 640×640 | 100 |
| Base | 1024×1024 | 256 |
| Large | 1280×1280 | 400 |
| Gundam | n ảnh 640×640 cộng 1 ảnh 1024×1024 | Thay đổi theo n |
Trang chữ thưa, hóa đơn đơn giản thì Tiny hoặc Small là đủ. Báo cáo dày chữ, bảng nhỏ thì nên dùng Base, Large hoặc Gundam.
Cài DeepSeek-OCR theo README
README ghi môi trường thử nghiệm là CUDA 11.8 và PyTorch 2.6.0. Các bước:
- Tải repo:
git clone https://github.com/deepseek-ai/DeepSeek-OCR.git
- Tạo môi trường Conda:
conda create -n deepseek-ocr python=3.12.9 -y
conda activate deepseek-ocr
- Tải file whl của vLLM 0.8.5 từ trang phát hành của vLLM, rồi cài thư viện:
pip install torch==2.6.0 torchvision==0.21.0 torchaudio==2.6.0 --index-url https://download.pytorch.org/whl/cu118
pip install vllm-0.8.5+cu118-cp38-abi3-manylinux1_x86_64.whl
pip install -r requirements.txt
pip install flash-attn==2.7.3 --no-build-isolation
- Sửa
INPUT_PATH,OUTPUT_PATHtrong fileconfig.pycủa thư mụcDeepSeek-OCR-master/DeepSeek-OCR-vllm, rồi chạypython run_dpsk_ocr_pdf.pycho file PDF hoặcpython run_dpsk_ocr_image.pycho ảnh.
Mẹo
Không muốn dựng vLLM? README có đoạn mẫu chạy bằng thư viện Transformers, gọi
model.infer(...)với ảnh và câu lệnh. Chậm hơn, nhưng đủ để thử vài chục trang trước khi quyết định.
Đem vào việc thật thế nào?
Số hóa hồ sơ scan. Quay lại ba dãy tủ ở đầu bài. Câu lệnh README gợi ý cho tài liệu:
<image>
<|grounding|>Convert the document to markdown.
Kết quả Markdown giữ được tiêu đề, bảng, sau đó đưa vào hệ thống tìm kiếm hoặc RAG. Lúc đó câu hỏi về điều khoản phạt chỉ còn là một lượt tìm. Anh chị nào đã dùng MarkItDown cho file Word, Excel có thể dùng DeepSeek-OCR cho phần ảnh scan mà MarkItDown không đọc được chữ.
Đọc biểu đồ trong báo cáo. Với hình vẽ, README có câu lệnh <image>\nParse the figure.. Với ảnh bất kỳ, dùng <image>\n<|grounding|>OCR this image. hoặc <image>\nFree OCR. khi không cần giữ bố cục.
Lưu ý
- Cần GPU NVIDIA: README dùng CUDA, flash-attention và ví dụ tốc độ trên A100-40G. Máy văn phòng không có GPU rời sẽ không chạy được theo hướng dẫn này.
- Tiếng Việt: tài liệu không nói về độ chính xác với tiếng Việt có dấu. Cần tự thử trên mẫu hồ sơ thật.
- Đây là nghiên cứu: ở mức nén 20 lần, độ chính xác chỉ khoảng 60%, không dùng cho chứng từ cần chính xác tuyệt đối.
- Điểm cộng về dữ liệu: chạy trên máy của mình thì hồ sơ không rời khỏi công ty.
Nhận xét của chuyên gia
DeepSeek-OCR đáng chú ý ở hai tầng. Tầng thực dụng: một model OCR mở, giấy phép MIT, chạy tại chỗ, xuất thẳng Markdown, hợp cho doanh nghiệp có hồ sơ giấy tồn đọng mà không muốn đẩy dữ liệu lên dịch vụ ngoài. Tầng ý tưởng: nếu nén ngữ cảnh bằng ảnh hiệu quả, chi phí cho agent đọc tài liệu dài có thể giảm đáng kể về sau.
Hợp với ai: ngân hàng, bảo hiểm, bệnh viện, công ty luật, bộ phận hành chính có kho tài liệu scan lớn và có đội kỹ thuật vận hành GPU.
Chưa hợp với ai: công ty nhỏ không có GPU và kỹ sư Linux; việc cần chính xác tuyệt đối như số tiền, số tài khoản mà không có bước người kiểm lại.
Cách bắt đầu của tôi: lấy 50 trang hồ sơ đại diện, chạy chế độ Base, cho nhân viên so với bản gốc, đếm lỗi, rồi mới quyết định quy mô. Đừng tin số trong bài báo khi chưa thử trên tài liệu tiếng Việt của chính mình.
Một câu để nhớ: DeepSeek-OCR hỏi một câu rất lạ mà rất hay: một bức ảnh có đáng giá hơn nghìn chữ, nếu tính bằng token?
Câu hỏi thường gặp
DeepSeek-OCR có miễn phí không?
Có. Repo dùng giấy phép MIT, model tải miễn phí trên Hugging Face với tên deepseek-ai/DeepSeek-OCR. Chi phí nằm ở phần cứng GPU để chạy.
DeepSeek-OCR đọc được tiếng Việt không?
Tài liệu không nói về tiếng Việt. Anh chị nên thử trên mẫu tài liệu thật của mình trước khi dùng.
Vision token là gì, vì sao ít lại tốt?
Vision token là các mẩu thông tin model rút ra từ ảnh. Càng ít token thì model xử lý càng nhanh, càng rẻ, miễn là vẫn đọc đúng nội dung.
Có cần vLLM mới chạy được không?
Không bắt buộc. README có cả cách chạy bằng thư viện Transformers.
Xem các mốc khác trong chuỗi dòng thời gian AI.
Nguồn tham khảo: https://github.com/deepseek-ai/DeepSeek-OCR