Auto Ontology là gì: NVIDIA dạy AI agent hiểu dữ liệu công ty
Auto Ontology là gì: thư viện mã nguồn mở của NVIDIA dựng bản đồ nghĩa cho dữ liệu, để AI agent hỏi database đúng, kèm SQL kiểm tra được.
Thử hình dung thế này. Anh giám đốc hỏi cậu nhân viên mới vào: "Doanh thu tháng 6 ở miền Nam bao nhiêu?". Cậu mở phần mềm kế toán, thấy hàng trăm bảng tên viết tắt, chọn đại một cột trông giống "doanh thu", cộng lại rồi báo một con số rất tự tin. Số đó có thể đúng, cũng có thể đã tính cả đơn bị hủy.
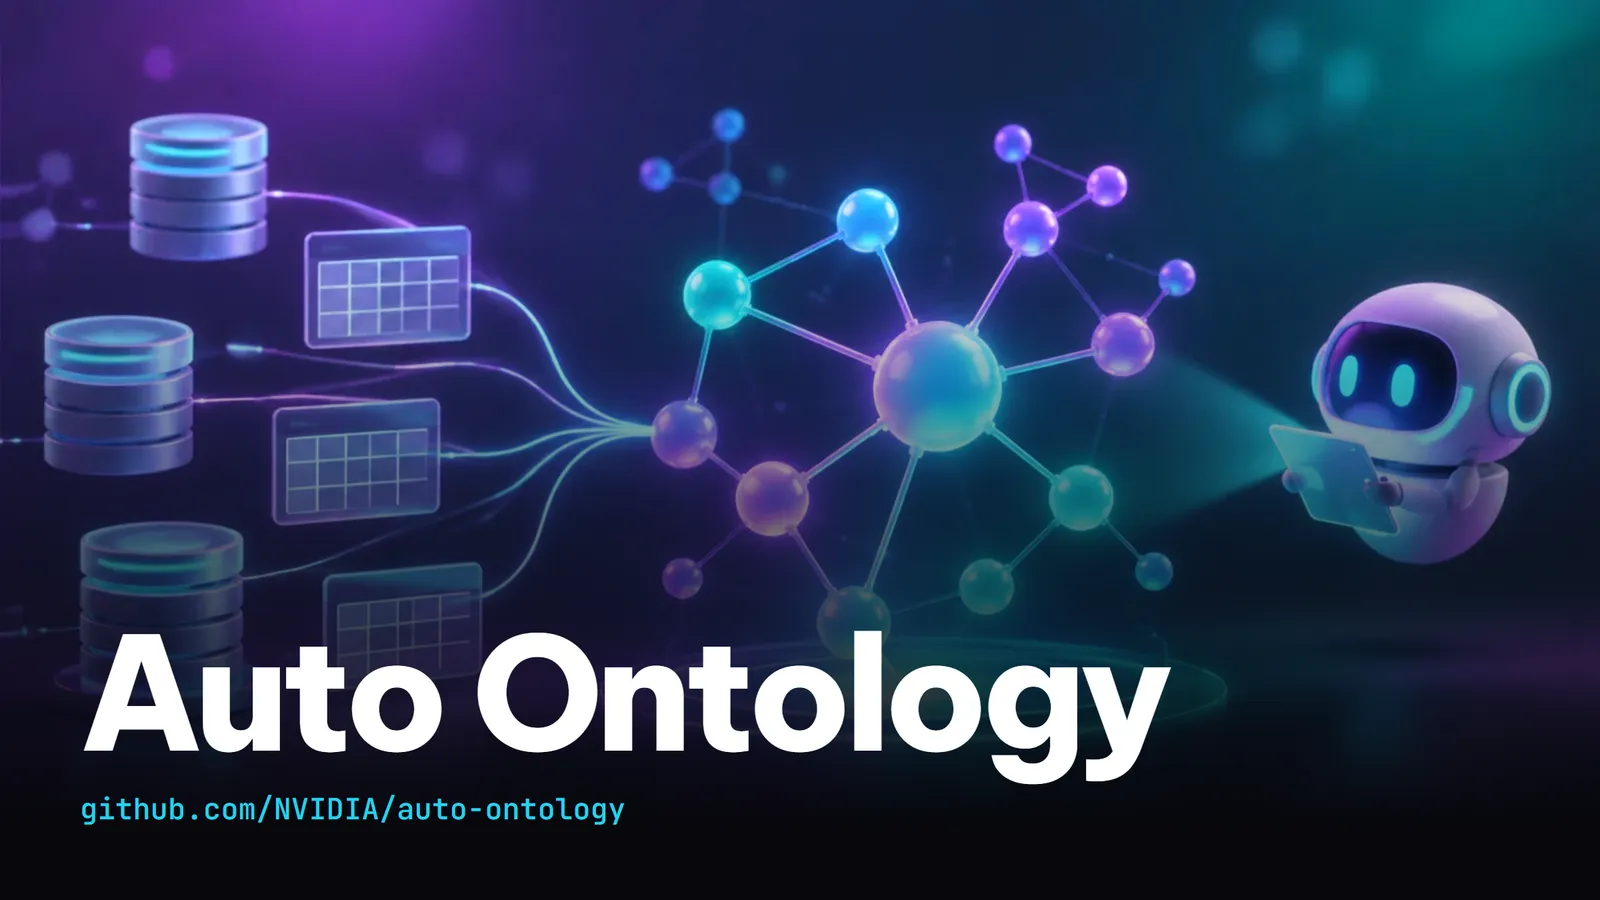
AI agent hỏi database của công ty đang ở đúng vị trí cậu nhân viên mới đó. Auto Ontology là gì? Đây là thư viện mã nguồn mở của NVIDIA, dùng để dựng một "bản đồ nghĩa" cho dữ liệu doanh nghiệp, để agent biết con số nằm ở đâu, tính thế nào, và nói "không biết" khi dữ liệu không có.
Đọc nhanh trong 30 giây
- Auto Ontology là thư viện mã nguồn mở (Apache 2.0) của NVIDIA, dựng lớp ngữ nghĩa cho database để AI agent trả lời câu hỏi bằng SQL đúng và có nguồn gốc.
- Cách làm: máy tự soạn bản nháp từ cấu trúc dữ liệu, người hiểu nghiệp vụ duyệt lại, agent dùng bản đã duyệt để trả lời.
- Chạy bằng Docker Compose, cần khóa API của NVIDIA; kết nối agent qua MCP, CLI hoặc REST API.
- Hợp với đội dữ liệu muốn cho nhân viên hỏi số liệu bằng tiếng thường.
- Đánh giá nhanh: hãng lớn đứng sau, tài liệu kỹ, cập nhật liên tục; nhưng chưa có bản phát hành chính thức, cài khá nặng và không nhận đóng góp từ ngoài.
Auto Ontology là gì, dùng vào việc gì?
Auto Ontology là framework Python của NVIDIA, xây một lớp "ngữ cảnh" nằm giữa AI agent và các database của công ty. Theo README, lớp này cho agent biết dữ liệu nằm ở đâu, mang nghĩa gì, có nên dùng không và dùng thế nào.
Ví von cho dễ hiểu: database giống một kho hàng khổng lồ không dán nhãn. Auto Ontology là cuốn sổ tay của thủ kho lâu năm: kệ nào để hàng gì, "hàng bán được" khác "hàng xuất kho" ra sao, muốn tính tồn thì cộng trừ những ô nào. Agent cầm sổ tay này thì không phải đoán.
Bản đồ nghĩa gồm ba loại định nghĩa:
| Loại | Là gì | Ví dụ |
|---|---|---|
| Terms (thuật ngữ) | Khái niệm kinh doanh, có mô tả, từ đồng nghĩa, gắn với cột dữ liệu | Khách hàng, Dòng hóa đơn |
| SQL attributes | Công thức SQL đã được duyệt, agent dùng lại mỗi lần | Biên lợi nhuận, tổng lũy kế |
| Relationships | Cách các bảng nối với nhau | Hóa đơn nối với khách hàng, thành phố |
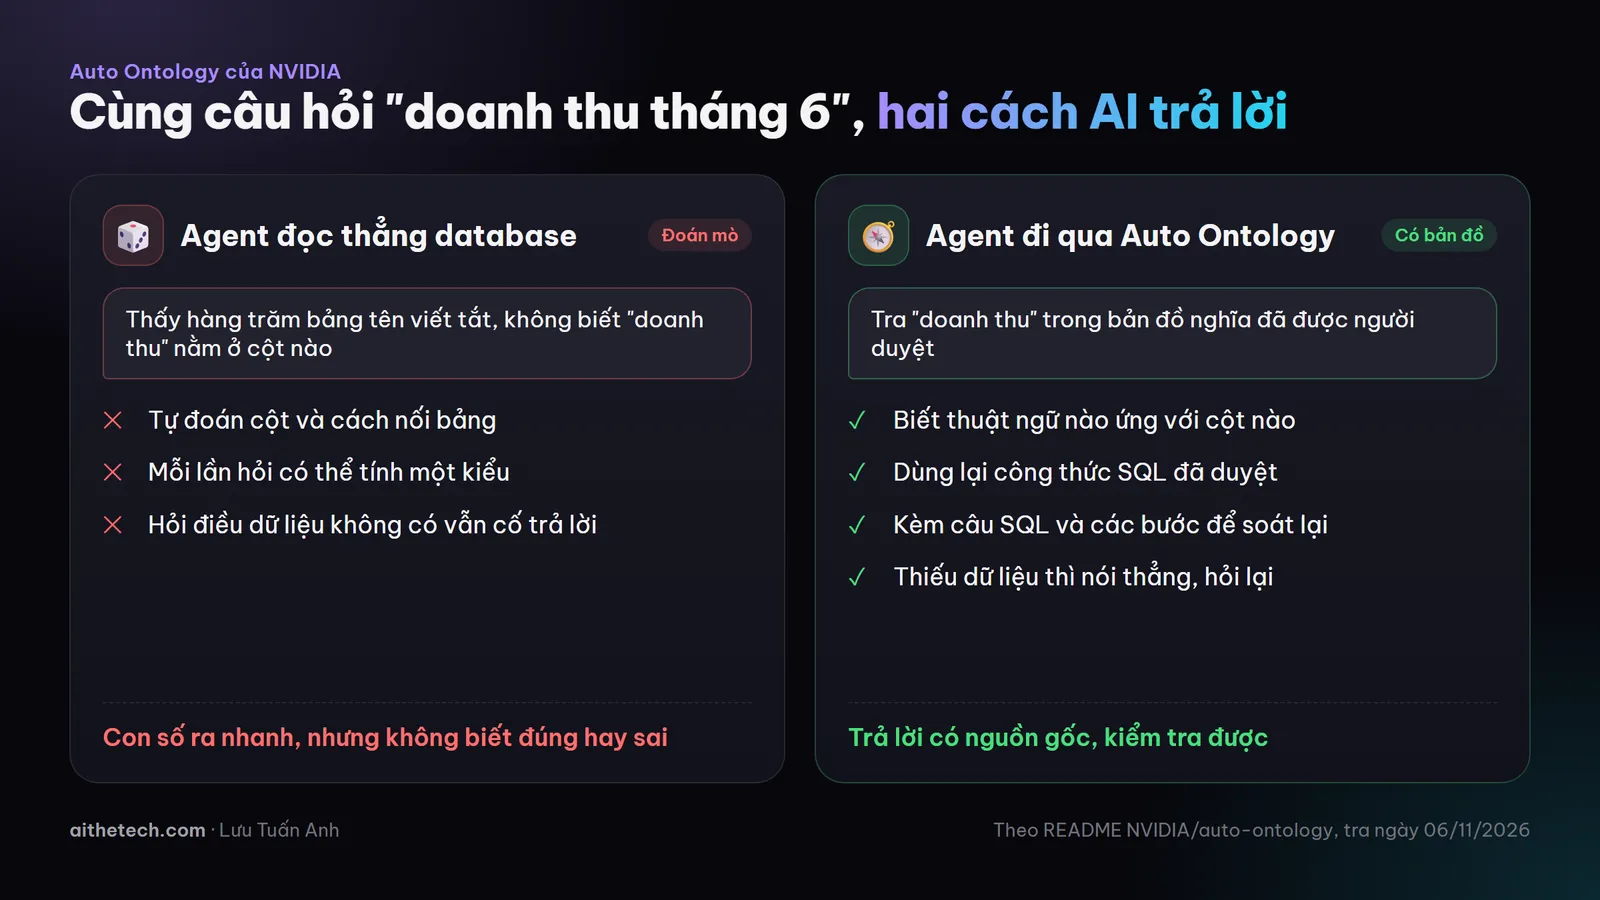
Cùng một câu hỏi, khác nhau ở chỗ agent có bản đồ hay không.
Đây là màn hình hỏi đáp thật trong README: agent trả lời câu hỏi về sản phẩm mang lại nhiều doanh thu nhất, kèm câu SQL đã sinh và biểu đồ.
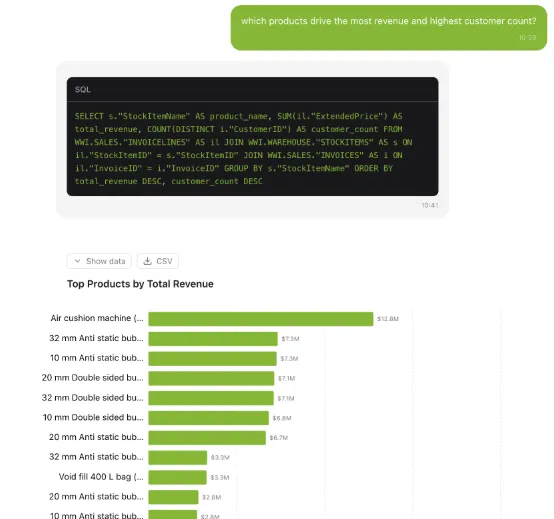
Hình: NVIDIA, repo auto-ontology (giấy phép Apache 2.0).
Auto Ontology hoạt động ra sao?
Auto Ontology chạy theo ba chặng: máy soạn bản nháp, người chứng nhận, agent trả lời từ bản đã chứng nhận.
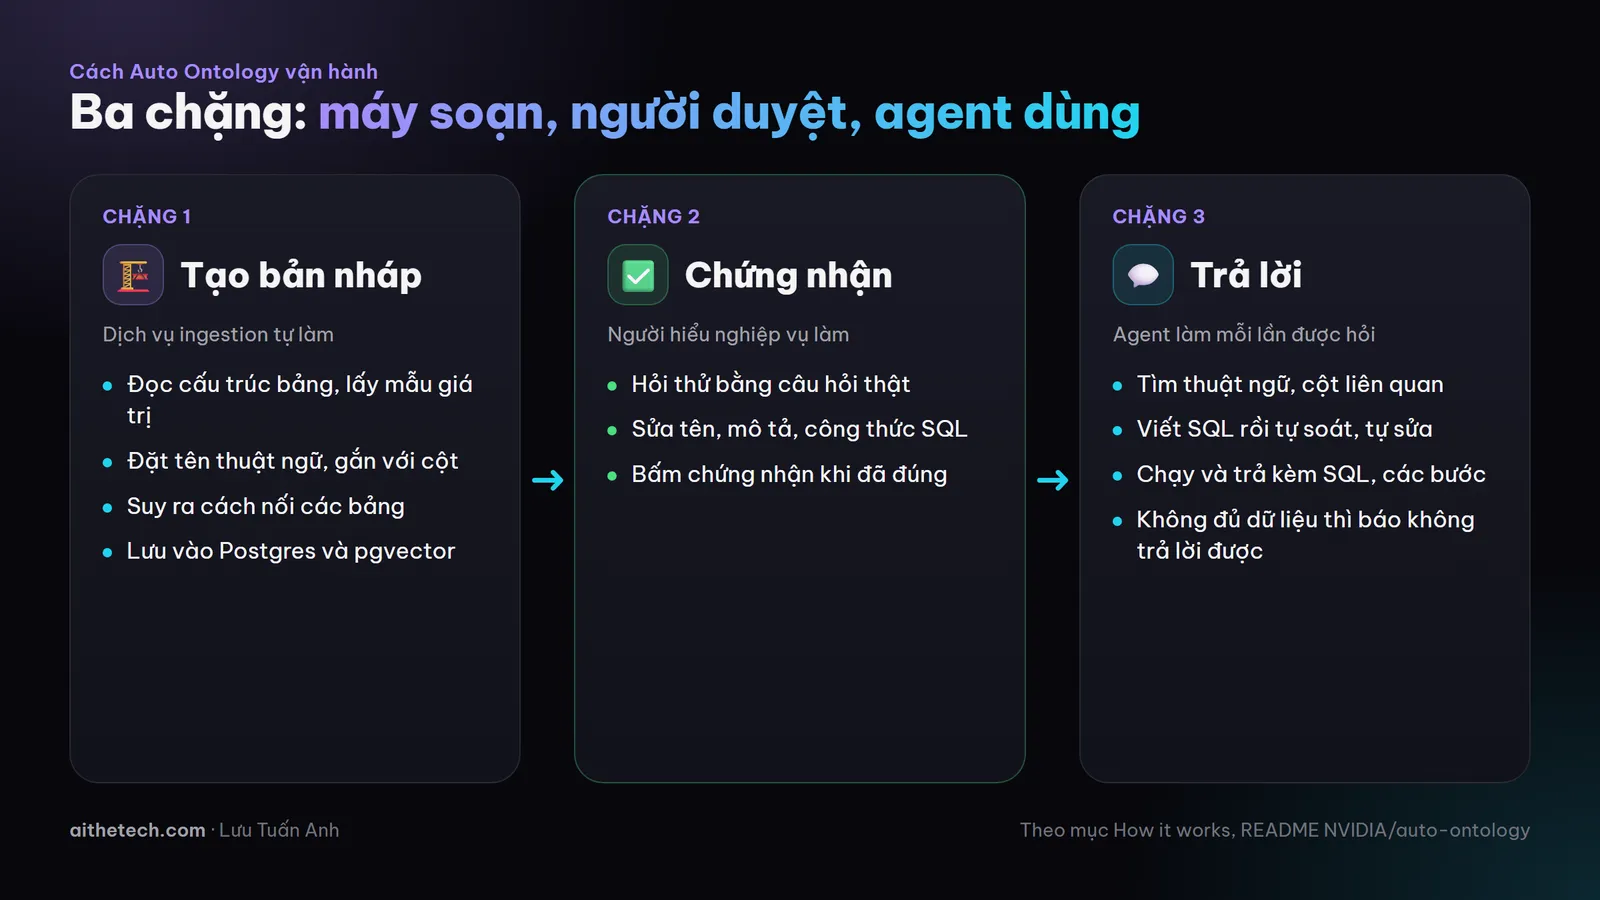
Máy làm phần nặng, người giữ phần quyết định.
- Tạo bản nháp. Dịch vụ ingestion đọc cấu trúc bảng, lấy mẫu giá trị, đặt tên thuật ngữ, suy ra cách nối bảng, rồi lưu vào Postgres kèm pgvector để tìm kiếm. Với database mẫu Wide World Importers, README ghi một lần biên dịch ra 31 thuật ngữ.
- Chứng nhận. Người hiểu nghiệp vụ hỏi thử bằng câu hỏi thật, sửa tên, mô tả, công thức, rồi bấm chứng nhận. Giống kế toán trưởng ký duyệt cách tính doanh thu một lần, từ đó cả phòng tính theo đúng một cách.
- Trả lời. Mỗi câu hỏi, agent tìm thuật ngữ liên quan, viết SQL, tự kiểm tra giá trị lọc và câu truy vấn, sửa nếu sai, chạy rồi trả kết quả kèm SQL và các bước đã làm.
Điểm tôi thích nhất nằm ở bước 3. Ví dụ trong README: hỏi về lợi nhuận trên chi phí quảng cáo, nhưng dữ liệu mẫu không có chi phí quảng cáo. Agent không bịa mà báo thiếu dữ liệu và hỏi lại người dùng.
Cài Auto Ontology thế nào?
Cách nhanh nhất là chạy bằng Docker Compose với database mẫu, theo mục Quickstart của README. Cần Docker có Compose v2, công cụ uv, và khóa API dạng nvapi-... lấy ở build.nvidia.com.
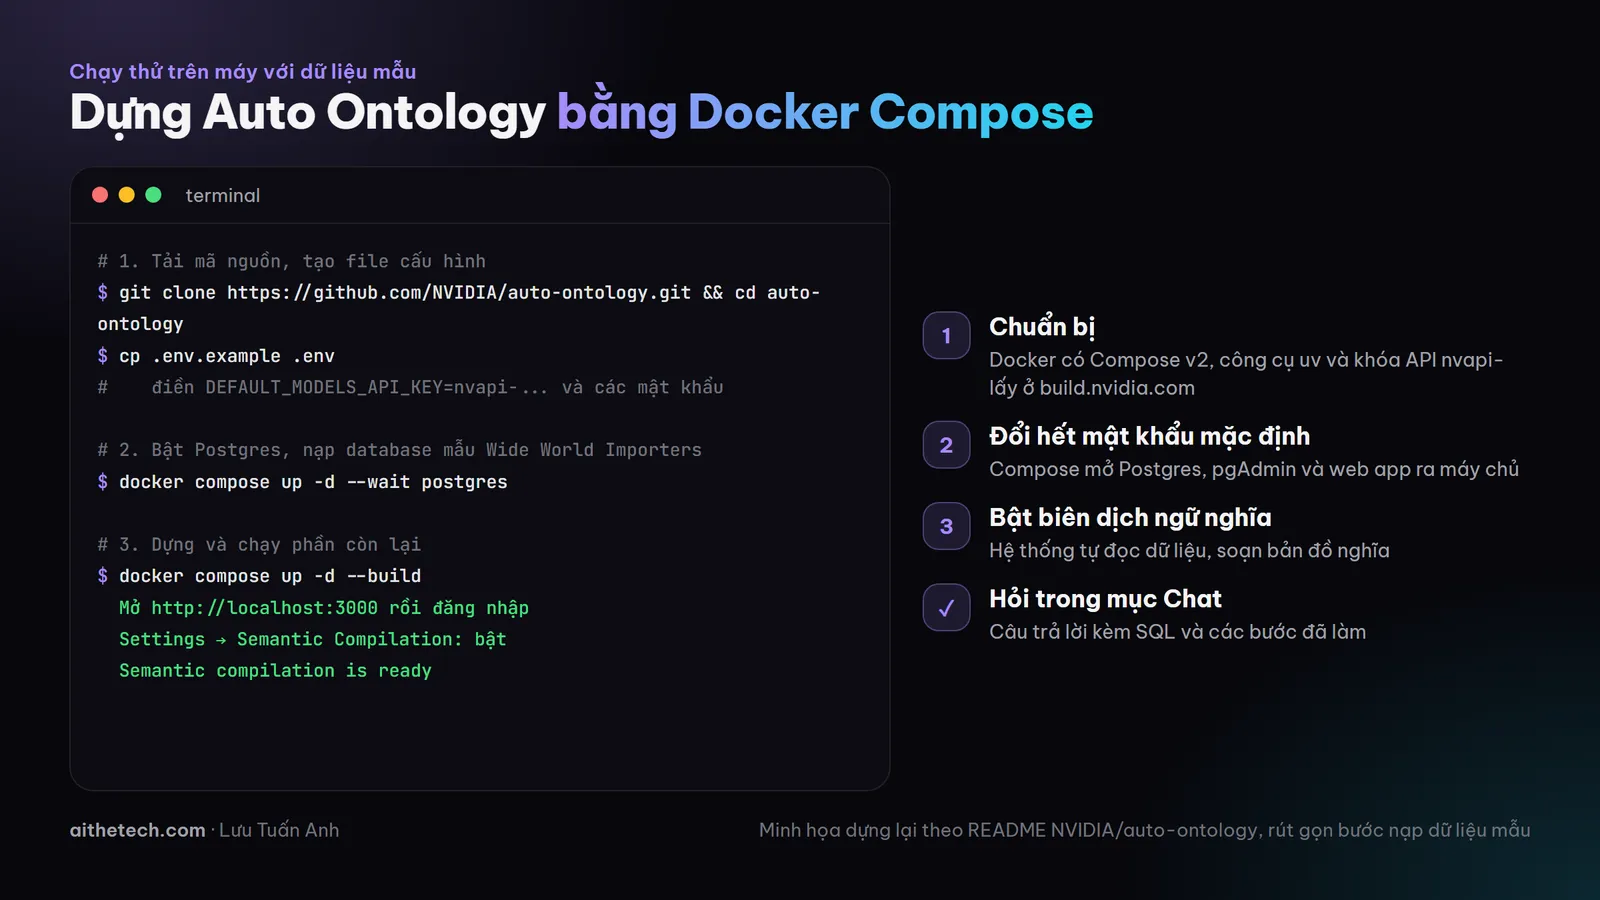
Minh họa dựng lại theo README, đã rút gọn bước nạp dữ liệu mẫu.
- Tải mã nguồn và tạo file cấu hình:
git clone https://github.com/NVIDIA/auto-ontology.git && cd auto-ontology
cp .env.example .env
- Mở
.env, điềnDEFAULT_MODELS_API_KEY,AUTH_SECRETvà đặt mật khẩu mới cho Postgres, tài khoản quản trị, pgAdmin. - Bật Postgres, rồi nạp database mẫu bằng script trong repo
NVIDIA/auto-ontology-eval(lệnh đầy đủ có trong README). - Dựng phần còn lại:
docker compose up -d --build
- Mở
http://localhost:3000, đăng nhập, vào Settings → Semantic Compilation để bật. Chờ báo "Semantic compilation is ready" rồi hỏi trong mục Chat.
Mặc định hệ thống gọi model nvidia/nemotron-3.5-lightning-30b-a3b qua NVIDIA NIM. README cho phép đổi sang endpoint tương thích OpenAI khác, miễn model hỗ trợ structured output.
Mẹo
Muốn agent quen thuộc như Cursor hay Claude Desktop hỏi được dữ liệu, dùng MCP server đi kèm. Server này chỉ đọc, có các công cụ như
check_answerable(câu hỏi này dữ liệu có trả lời được không) vàask_question. Mỗi người dùng đăng nhập riêng, mọi lệnh chạy theo quyền của người đó.
Ví dụ dùng thực tế trong doanh nghiệp
Thử hình dung một công ty phân phối có dữ liệu bán hàng trong PostgreSQL. Phòng dữ liệu kết nối database vào Auto Ontology, cho máy soạn bản nháp, rồi mời trưởng phòng kinh doanh ngồi duyệt các thuật ngữ "doanh thu", "khách hàng mới", "đơn hủy". Sau đó, trưởng vùng chỉ cần gõ vào Chat:
Doanh thu mặt hàng X ở khu vực Y trong tháng 6 là bao nhiêu?
Câu trả lời trả về kèm SQL. Ai nghi ngờ con số thì đưa câu SQL đó cho người làm dữ liệu soát.
Với đội kỹ thuật, có thể gọi thẳng REST API POST /api/chat/completions bằng token tạo trong mục API Tokens, để nhúng hỏi đáp số liệu vào công cụ nội bộ. Auto Ontology kết nối được mười loại database, trong đó có PostgreSQL, MySQL, Snowflake, Databricks, ClickHouse, DuckDB và SQLite.
Auto Ontology có đáng tin không? Soi nhanh trên GitHub
Auto Ontology có 7.247 sao và 572 fork, nhưng chưa có bản phát hành chính thức nào. Số sao giống hàng người xếp trước quán mới khai trương: cho biết nhiều người tò mò, chưa nói được món ăn có ngon đều sau ba tháng hay không.
| Tiêu chí | Bằng chứng | Mức |
|---|---|---|
| Độ quan tâm | 7.247 sao, 572 fork; trong top GitHub Trending ngày 06/11/2026 | Tốt |
| Độ chín | 1.366 commit từ 06/04/2026; commit mới nhất nâng phiên bản lên 1.2.0; 0 bản phát hành; có thư mục test | Trung bình |
| Bảo trì | Commit gần nhất ngày 05/11/2026; 32 issue và 25 pull request đang mở; nhóm NVIDIA tự bảo trì, không nhận pull request từ ngoài | Trung bình |
| Giấy phép | Apache 2.0, kèm danh sách thành phần bên thứ ba | Tốt |
| Quyền truy cập/Bảo mật | Có đăng nhập, phân quyền, tùy chọn lưu mật khẩu kết nối trong Vault; README cảnh báo cổng 3001, 3002 phải để trong mạng riêng | Trung bình |
Số liệu tra bằng GitHub API ngày 06/11/2026.
Góc nhìn phản biện
Cảnh báo
- Dữ liệu đi qua model bên ngoài. Mặc định agent gọi model trên API của NVIDIA. Dữ liệu nhạy cảm thì cân nhắc NIM tự host hoặc endpoint nội bộ trước khi kết nối database thật.
- Cổng nội bộ không có bảo vệ riêng. README ghi dịch vụ ingestion (cổng 3002) không tự xác thực, backend (cổng 3001) tin danh tính do frontend chuyển qua. Không mở hai cổng này ra Internet.
- Tính năng dự đoán gửi bảng đi. Bật KumoRFM thì agent tải các bảng đã kết nối lên dịch vụ của Kumo. Chỉ bật sau khi duyệt dữ liệu với bộ phận pháp chế.
- Chưa có bản phát hành ổn định. Nên thử trên database mẫu hoặc bản sao, chưa đưa vào báo cáo chính thức.
- Bản nháp chưa phải sự thật. Thuật ngữ do máy soạn có thể hiểu sai nghiệp vụ. Bỏ bước chứng nhận là mất đúng giá trị của công cụ.
Auto Ontology giống một bộ khung sổ tay thủ kho in sẵn: rất đỡ công, nhưng người trong nghề vẫn phải ghi vào đó những gì công ty mình thực sự làm.
Lưu ý
Quickstart cần khá nhiều thành phần: Postgres, pgAdmin, frontend Next.js, backend FastAPI, dịch vụ ingestion. Máy cá nhân yếu sẽ chạy chậm, và cần quen Docker mới cài suôn.
Nhận xét của chuyên gia
Khi tư vấn đưa AI vào phân tích số liệu cho doanh nghiệp, câu tôi nghe nhiều nhất là "AI trả lời nhanh nhưng tôi không dám dùng số đó". Vấn đề hiếm khi nằm ở model. Nó nằm ở chỗ mỗi phòng hiểu "doanh thu" một kiểu, và chẳng ai ghi lại. Auto Ontology tấn công đúng chỗ đó, thêm cách làm tôi thấy rất hợp lý: máy soạn nháp, người ký duyệt.
Hợp với ai: công ty đã có database bán hàng, kho, tài chính tương đối gọn; có ít nhất một người làm dữ liệu biết Docker và SQL; muốn cho quản lý hỏi số liệu bằng câu thường.
Chưa hợp với ai: doanh nghiệp còn quản lý chủ yếu bằng file Excel rời rạc; nhóm không có người kỹ thuật; nơi không được phép gửi dữ liệu ra ngoài mà chưa có hạ tầng model nội bộ.
Cách bắt đầu của tôi: chạy Quickstart với database mẫu Wide World Importers, hỏi thử vài câu và soi câu SQL trả về. Thấy ổn mới thử với một bản sao nhỏ của dữ liệu thật, chọn một phòng ban, duyệt chừng mươi thuật ngữ quan trọng nhất.
Muốn xem một hướng khác của AI agent, anh chị có thể đọc bài agent-desktop, nơi agent điều khiển phần mềm trên máy tính.
Một câu để nhớ: agent hỏi dữ liệu giỏi đến đâu là do cuốn sổ tay nghĩa mà người trong công ty đã duyệt cho nó.
Câu hỏi thường gặp
Auto Ontology có miễn phí không?
Mã nguồn miễn phí theo giấy phép Apache 2.0. Chi phí nằm ở model: mặc định gọi API của NVIDIA bằng khóa nvapi-, hoặc anh chị tự host model.
Auto Ontology kết nối được những database nào?
Theo README, Auto Ontology kết nối mười loại: PostgreSQL, MySQL, Databricks, Snowflake, ClickHouse, Trino, Apache Kyuubi, HeavyDB, DuckDB và SQLite.
Có dùng Auto Ontology với Claude hay Cursor được không?
Được, qua MCP server đi kèm. README có sẵn mẫu cấu hình cho Cursor và Claude Desktop; server chỉ đọc và chạy theo quyền của người đăng nhập.
Auto Ontology khác gì cho AI đọc thẳng database?
Khác ở chỗ agent dựa vào thuật ngữ, công thức và cách nối bảng đã được người duyệt, thay vì tự đoán từ tên bảng. Mỗi câu trả lời kèm SQL và các bước để kiểm tra lại.
Nguồn: NVIDIA, README repo auto-ontology, 05/11/2026. Ngày tra nguồn: 06/11/2026.
Nguồn tham khảo: https://github.com/NVIDIA/auto-ontology